Qwen3-TTS :从模型架构到 RKNN 板端部署
Qwen3-TTS :从模型架构到 RKNN 板端部署
- Qwen3-TTS 是怎么把一段文字变成一段语音的?
- Qwen3-TTS 模型内部长什么样?
- 以瑞芯微平台为例,我们是怎么把它搬到开发板上跑的,以及每一步为什么要那么做?
1. TTS 是啥?
TTS 全称为 Text To Speech,文字转语音。
输入一句文本:“你好会上班呀~”,模型输出一段能播放的音频(wav 文件)。这个过程难点在哪?
- 声音是连续的波形,一秒就有 24000 个采样点。直接逐点预测波形,太难了。
- 同样一句话,可以说得温柔、可以说得严肃。模型得能控制。
- 用户只想等零点几秒就听到声音,不能等半分钟。
Qwen3-TTS 的思路是:
1 | |
2. 8 个基础概念
这些词后面会反复出现,先花两分钟认识它们。
| 概念 | 大白话解释 |
|---|---|
| Token(词元) | 模型眼里的最小单位。文字被切成 token,声音也被切成 token。模型只认编号,不认字,也不认声音。 |
| Embedding(嵌入向量) | 每个编号对应的一串数字(比如 2048 个小数),可以理解为这个编号的数字名片。模型真正计算的是这些向量,不是编号本身。 |
| 神经网络 | 一大堆可以调节的旋钮(参数/权重)。输入进来,经过层层计算,输出结果。训练就是反复拧旋钮,直到输出像样。 |
| 语言模型(LM) | 专门做接龙的模型:看到前面的内容,预测下一个 token。ChatGPT 就是靠这个写文章的。 |
| 自回归(Autoregressive) | 接龙的工作方式:每次只预测 1 个,把结果拼回去,再预测下一个,一步接一步。 |
| Codebook(码本) | 一本编号到向量的字典。声音被量化后,每一帧都变成字典里的一个编号。 |
| NPU | 专门做神经网络计算的芯片。开发板(比如 RK3588)里就有 NPU。 |
| 量化(Quantization) | 把模型里的数字从精确的 32 位浮点,压缩成 8 位整数甚至 4 位整数。模型变小、变快,精度略降。 |
忘了没关系,用到时都会再解释一遍。
3. 核心思想一:把声音变成编号
概念备齐了,先讲两个核心思想里的第一个。
3.1 为什么不直接生成波形
一段 1 秒的音频,24kHz 采样率,就是 24000 个浮点数。
如果让模型直接输出这 24000 个数,就像让人用画笔一个像素一个像素地画照片。太慢了,也太难学。
聪明的办法是压缩。
把每秒 24000 个采样点,压缩成每秒两百个左右的编号;需要播放时,再用解码器把编号还原成波形。
这一对压缩器加还原器,合称 Speech Tokenizer(语音分词器)。
- 压缩方向:音频 → 一串编号(codec tokens)
- 还原方向:一串编号 → 音频
3.2 Qwen3-TTS 有两个 Tokenizer
| Tokenizer-25Hz | Tokenizer-12Hz | |
|---|---|---|
| 每秒出多少帧编号 | 25 帧 | 12.5 帧 |
| 每帧几路编号 | 1 路(一本码本) | 16 路(16 本码本) |
| 还原器 | DiT(扩散模型)+ BigVGAN,重 | 轻量卷积网络(ConvNet),轻 |
| 特点 | 语义信息强,适合长文本 | 帧率低、延迟极低,适合实时 |
| 首包延迟 | 约 150 ms | 约 97~101 ms |
Hz 是什么意思?就是每秒切几帧。12.5 Hz = 每 80 毫秒一帧。
RKNN demo 用的是 12Hz 版本,因为延迟低、解码器轻,适合板端。下面只讲它。
3.3 12Hz Tokenizer 的 16 路编号是什么
想象你要向别人描述一幅画:
- 第 1 条描述:画的是个人,在笑 —— 这是语义,决定内容是什么。
- 第 2~16 条补充:光线偏暖、笔触细腻、左下角有点阴影 —— 这些是细节,对应音色、语气、韵律。
12Hz Tokenizer 就是这个思路:
1 | |
技术上这叫 RVQ(残差向量量化):
- 先用第 1 本码本近似原始信号,记下误差(残差)。
- 再用第 2 本码本近似这个误差,再记残差。
- 一层层补,越往后越细。
每本码本有 2048 个条目,所以每路编号的取值范围是 0~2047。
一帧 = 16 个编号,每个编号 0~2047。
一秒 12.5 帧,也就是每秒 200 个编号。
对比原始音频一秒 24000 个数 —— 压缩了 100 多倍。
这个压缩比,就是语言模型能接管声音生成的前提:200 个 token/秒的接龙游戏,模型擅长。
4. 核心思想二:像接龙一样一个字一个字生成
编号的来路清楚了,接下来看这些编号是怎么被生成出来的。
4.1 说话这件事,变成了预测下一个编号
训练好的 Qwen3-TTS 主体(源码里叫 talker),本质是个语言模型。
它的工作和 ChatGPT 一模一样:
看到前面的所有输入 → 预测下一个 token。
区别只在预测对象:
- ChatGPT 预测的下一个 token 是文字。
- talker 预测的下一个 token 是声音的第 1 路编号。
4.2 双轨制:文字一条轨,声音一条轨
这里有个关键设计,叫 dual-track,双轨。
说话时,文字和声音是同步推进的:
1 | |
- 文字轨决定接下来说什么。
- 声音轨决定用什么声音说出来。
- 两条轨的向量在每个时间步相加,一起喂进模型。
好处是文字可以流式输入:上游大模型吐出一个字,TTS 就能开始配一帧声音,不用等全文到齐。这就是低延迟的来源。
4.3 每一步生成的完整动作
这是整个系统最核心的循环。每一步发生 4 件事:
1 | |
其中:
- talker 是主力,大模型(1.7B 或 0.6B 参数),负责全局决策:说什么、什么节奏、什么时候停。
- code_predictor 是小助手(源码里也叫 MTP,Multi-Token Prediction 模块),小模型,只干一件事:已知第 1 路,补齐另外 15 路。
分开的理由:如果让 talker 一次预测 16 路编号,任务太难、序列太长。拆开之后,语义的骨架归 talker,细节的血肉归 code_predictor,各干各擅长的。
4.4 什么时候停
talker 每步都在预测下一个编号。当它预测出一个特殊的 EOS(结束)编号,整段生成停止。
4.5 声音从哪来:流式解码
声音轨每产出一帧编号,理论上就能立刻解码成 80ms 音频。
实际上为了避免太碎(调度开销大),每攒 4 帧(约 320ms 音频)解码一次。
所以用户体验是:说完话约 0.1 秒,第一小段声音就出来了。后面边生成边播,完全不用等整句合成完。
5. Qwen3-TTS 的整体架构
两个核心思想拼在一起,就是完整的架构。
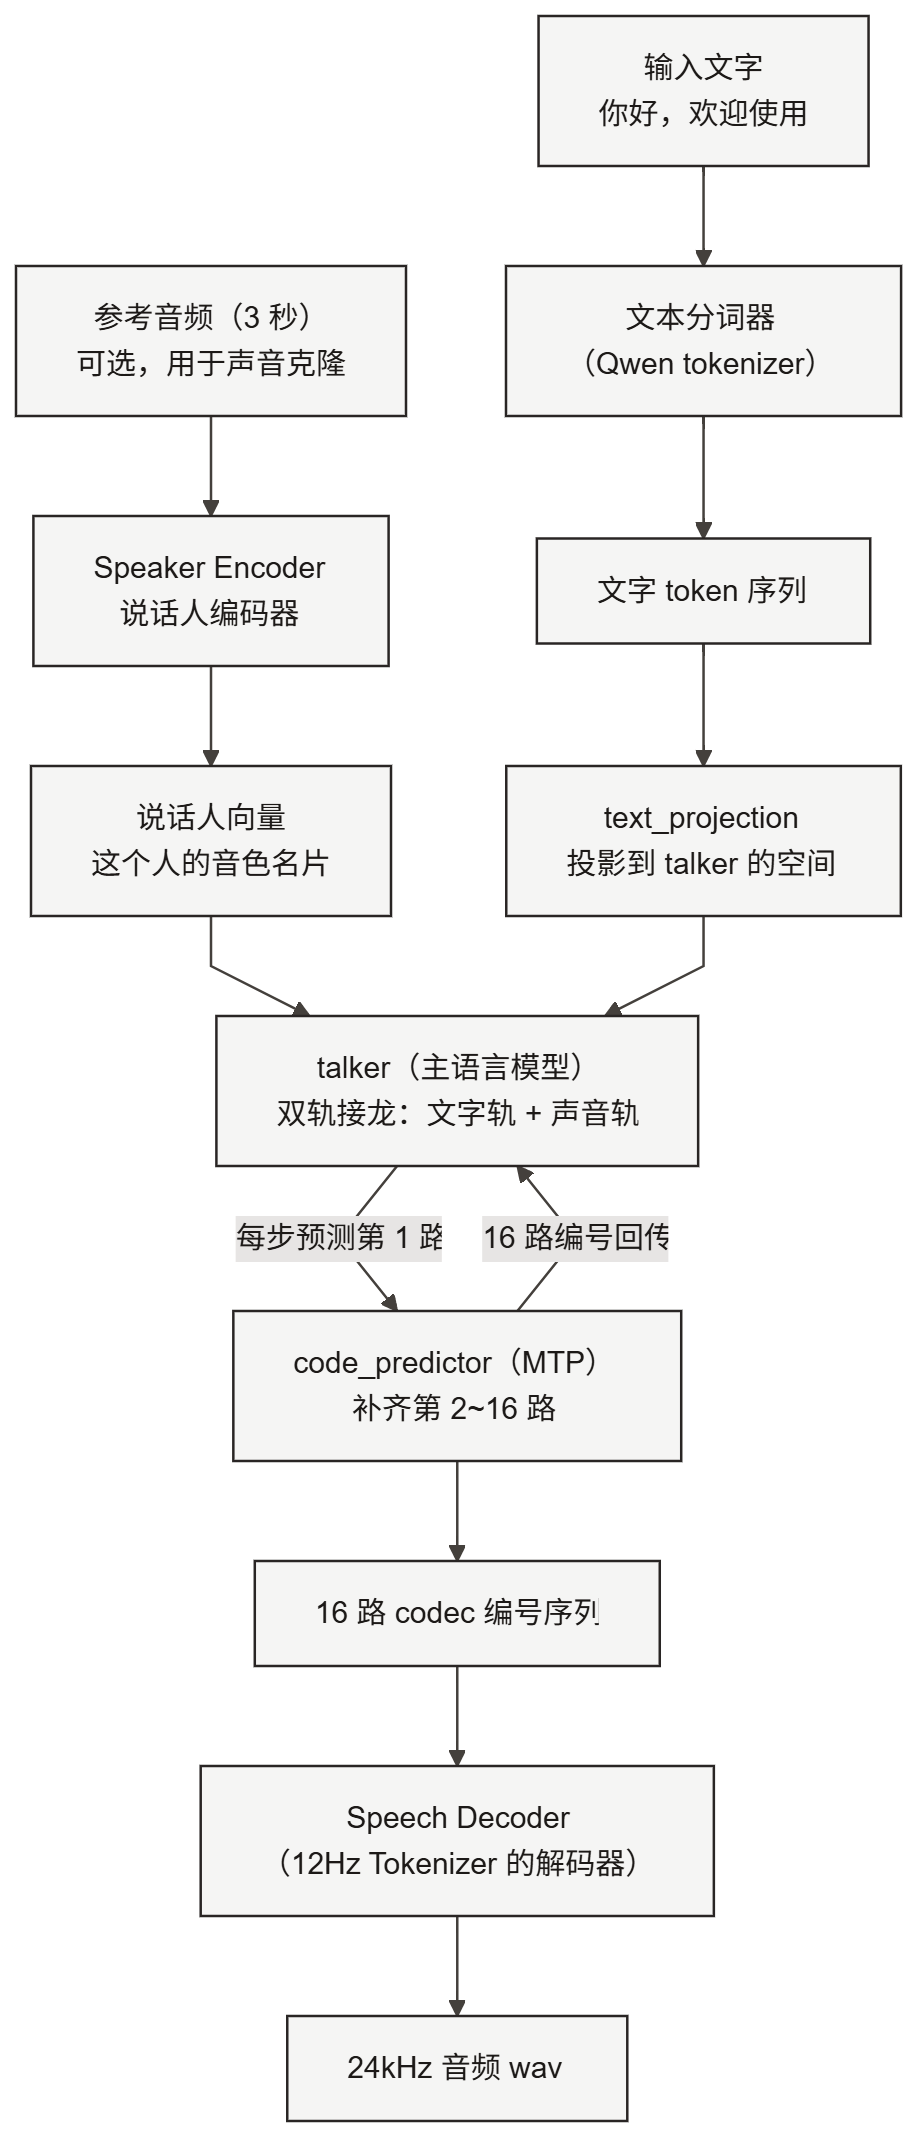
几个要点:
- 文字侧:普通 Qwen 文本分词器,把文字切成编号,再查表成向量,投影到 talker 需要的尺寸。
- 音色侧:想要克隆谁的声音,就把谁的 3 秒音频喂给 Speaker Encoder,得到一个音色向量,拼在输入最前面。模型听到这个向量,就知道该用谁的嗓子说话。
- 生成侧:talker + code_predictor 循环接龙,产出 16 路编号。
- 还原侧:Speech Decoder 把编号流还原成波形。它是一个轻量因果卷积网络,因果的意思是只看过去、不看未来,所以能边收边解码,这是流式低延迟的关键。
模型家族有哪些
| 版本 | 大小 | 特点 |
|---|---|---|
| 12Hz-1.7B-Base | 17 亿参数 | 支持 3 秒声音克隆,RKNN demo 用的就是它 |
| 12Hz-0.6B-Base | 6 亿参数 | 更小更快,首包延迟 97 ms |
| 12Hz-CustomVoice | — | 预设音色 + 指令控制风格 |
| 12Hz-VoiceDesign | — | 用一句自然语言描述,凭空定制新音色 |
| 25Hz 系列 | — | 长文本更稳,适合有声书类场景 |
训练数据:500 万小时以上语音,覆盖 10 种语言(中、英、日、韩、法、德、西、葡、意、俄)。
6. 模型内部拆开看
这一节把架构里的每个模块拆开看。稍微深入一点,但只讲结构,不讲公式。
6.1 talker:相同结构的层叠起来
talker 基于 Qwen3 语言模型。结构是标准 Transformer decoder:
1 | |
几个关键数字(来自源码与 RKNN 头文件):
| 项目 | 值 | 含义 |
|---|---|---|
| 隐藏层维度 | 2048 | 每个向量的长度 |
| talker 词表 | 3072 | talker 认识的编号总数 |
| codec 词表 | 2048 | 每路声音编号的取值数 |
| 文本词表 | 151936 | 文字 token 数(Qwen 词表) |
| 最大上下文 | 8192 | 一次能记住的历史长度 |
先说注意力机制。每生成一步,模型会回头扫一遍之前的所有输入,给每个历史位置打一个相关度分数,再按分数加权提取信息。就像你读到“他”这个字时,大脑自动回去找“他”指的是谁。
再看 KV Cache。既然每步都要回头看历史,每次都从头重算就太浪费了。于是把历史算好的中间结果(K 和 V)缓存起来,下次直接用,这就是 KV Cache。它很占内存,这一点在 RKNN 部署时会再提到。
6.2 code_predictor:缩小版的接龙模型
结构和 talker 类似,但小得多。
它的输入是:
- talker 当前步的内部状态(past_hidden,可以理解为 talker 对前文的总结)
- 第 1 路编号的向量
它的输出是:依次预测第 2、3、……、16 路编号。
一次生成循环里,talker 走 1 步,code_predictor 就要走 15 步。好在它很小,负担不重。
6.3 Speaker Encoder:音色提取器
结构是一个经典的声音识别网络(ECAPA-TDNN 风格:Res2Net + 注意力池化)。
工作方式:
1 | |
这个向量就是说话人的音色档案。它跟具体说了什么无关,只跟是谁的声音有关。
6.4 Speech Decoder:编号还原器
12Hz 版本的解码器是个轻量因果卷积网络。
- 卷积网络:擅长处理局部模式,相当于拿一个滑动窗口顺次扫过数据,计算量比注意力模型小得多。
- 因果:每个输出只用过去和当前的输入,不等未来。所以音频能像流水一样边算边出。
- 上采样:每帧编号(80ms)要放大成 1920 个采样点(24000Hz × 0.08s = 1920)。这个数字在 C++ 代码里就叫
kTotalUpsample = 1920。
7. 训练过程速览
结构看完了,再速览一下它是怎么练出来的。这一节了解即可,不影响理解部署。
预训练分三个阶段:
- 通才阶段:500 万小时多语言语音,学会文字和声音的基本对应。
- 提质阶段:筛选高质量数据继续训,去掉噪声数据带来的坏毛病。
- 长文本阶段:把上下文从 8K 拉到 32K,学会处理长内容,稳定生成 10 分钟以上。
后训练也分三个阶段:
- DPO(人类偏好对齐):让人类评判哪个合成更好听,让模型往好听的方向靠。
- 规则奖励强化学习(GSPO):进一步提升稳定性和指令跟随能力。
- 说话人微调:针对特定音色做精调,得到 CustomVoice 版本。
概括起来:学得多、学得精、学得听话。
8. RKNN 部分:为什么要搬上开发板
到这里,模型本身的原理讲完了。接下来换一个视角:怎么把它从服务器搬进开发板。
8.1 场景与动机
原版 Qwen3-TTS 跑在服务器 GPU 上。但很多场景需要端侧运行:
- 车载座舱 —— 网络可能不好,也不想把语音数据传到云端(隐私)。
- 智能音箱、机器人 —— 要离线可用,要响应快。
- 成本 —— 一块开发板比 GPU 服务器便宜得多。
目标硬件是瑞芯微(Rockchip)的 SoC,比如 RK3588 / RK1820。这些芯片里有 NPU(神经网络处理器)。
RKNN 就是瑞芯微 NPU 的软件栈:
1 | |
8.2 三个现实困难
直接把原版模型搬过去是不行的,有三个拦路虎:
| 困难 | 解释 |
|---|---|
| 内存太小 | 1.7B 参数,按 16 位浮点存要 3.4 GB。板子内存常常只有几个 GB,还得分给系统和其他程序。 |
| 算力太弱 | NPU 的算力远低于 GPU。浮点计算原样跑,一句话可能要等几十秒。 |
| 格式不通 | NPU 不认识 PyTorch 模型。它只吃 RKNN 格式的模型,且喜欢形状固定的计算图。 |
对应的三板斧:拆模型、做量化、写 C++ 编排。下面逐一讲。
8.3 总体部署流水线
1 | |
- ONNX:一种通用的模型交换格式,PyTorch 先导出成它,RKNN 工具链再从它转换。
- 量化发生在 ONNX → RKNN 这一步。
先看量化。
9. RKNN 量化:怎么把模型变小
9.1 量化是什么
模型里存着几十亿个旋钮值,也就是权重。默认每个值用 32 位浮点数存(fp32),精确但占地方。
量化的思路,是用更少的位数近似表示这些数。
打个比方:
- fp32 像用卷尺量到毫米。
- int8 像用刻度到厘米的尺子。
- int4 像只能精确到大约一拃。
大多数时候,厘米精度足够把活干好。
写法约定:
- w4a16:权重(weight)用 4 位整数,激活值(activation,计算的中间结果)用 16 位浮点。
- w8a16:权重 8 位,激活 16 位。
权重部署后就不变了,可以放心压得狠一点;激活值随输入变化,得保守一些。
效果:w4a16 相比 fp16,权重体积直接砍到约 1/4。1.7B 的 talker 从约 3.4 GB 压到 1 GB 以内,板子才装得下。
9.2 每个模块的量化方案不一样
RKNN demo 把整个 TTS 拆成了 5 块,每块用不同策略,这是本 demo 的核心设计:
| 模块 | 作用 | 量化方案 | 为什么这么选 |
|---|---|---|---|
| embeds(3 张表) | 编号 → 向量的查找表 | 不量化,直接存 fp16 裸文件 | 查表不需要计算,放内存里让 CPU 查就行,根本不进 NPU |
| text_projector | 把文字向量投影到 talker 空间 | 不量化(fp16),单核运行 | 就是个两层小 MLP,小到无所谓,量化反而可能掉精度 |
| talker | 主力生成模型 | w4a16 + GRQ 算法 + 真实数据校准 | 最大最重的模块,必须压到 4 位才装得下;用最好的算法和校准数据保精度 |
| code_predictor | 补齐 2~16 路编号 | w8a16 | 中等大小;它每步要跑 15 次,误差会层层放大,所以比 talker 保守,保 8 位 |
| speech_decoder | 编号 → 波形 | 不量化(fp16) | 直接决定听感,最敏感;好在它本身很轻,不量化也跑得动 |
总结出一条选型逻辑:
越大的越狠压,越影响最终观感的越不压,纯查表的干脆不进 NPU。
9.3 校准数据:量化的考前模拟
w4/w8 量化有个关键问题:每个数的取值范围压到多宽?
- 范围定太小,大数被削顶,失真。
- 范围定太大,小数挤在一起分不清,也失真。
做法是拿真实输入跑一遍,看看数值实际分布在什么范围。
这就是校准(calibration)。demo 里的流程:
1 | |
这也解释了为什么 talker 用 GRQ 算法(瑞芯微针对 LLM 的高质量量化算法)加真实校准,而 code_predictor 只用普通算法(normal)—— 后者输入形态简单,不需要大阵仗。
9.4 自回归模型的特殊处理:两种输入形状
talker 是接龙模型,一生中有两种时刻:
- Prefill(读题):第一次把整段输入(提示词、文字、音色向量)一次性喂进去,并行算完。形状是
[1, 128, 2048](128 是示例长度)。 - Decode(答题):之后每步只喂 1 个新 token。形状是
[1, 1, 2048]。
NPU 喜欢固定形状,所以 RKNN 转换时用 dynamic_input 显式声明这两套形状,让一张模型支持两种模式。
同时配置 KV Cache:
- talker 的缓存长度开 2048,用 fp16 存 —— 因为上下文长。
- code_predictor 的缓存只开 32 —— 它每轮只跑 15 步,够用了。
省下来的每一 MB 内存,对板子都宝贵。
9.5 Embedding 表为什么单独拎出来
三张表(文字表 151936×2048、talker 表 3072×2048、codec 表 15×2048)如果塞进 NPU 计算图:
- 图变大,转换慢。
- 查表本质上是按编号取一段内存,CPU 直接 memcpy 就行,根本用不上 NPU。
所以 demo 把它们导出成 fp16 裸二进制文件(*.fp16.bin),板端 C++ 用内存映射(mmap)直接读。简单、快、省 NPU。
10. 板端推理:C++ 是怎么跑起来的
模型文件就位,剩下的问题是怎么把它们组织成一条能实时出声的流水线。
10.1 运行时有哪些文件
1 | |
10.2 一次合成的完整流程
以“你好,欢迎使用”为例:
1 | |
采样参数也写在 C++ 里:talker 用 top_k=50, temperature=0.9, 重复惩罚=1.05;code_predictor 类似但不做重复惩罚。
10.3 双线程流水线:一边生成,一边出声
如果先生成完所有编号,再统一解码,用户要等很久才听到声音。
demo 用了生产者-消费者模式:
1 | |
两个线程同时干活。用户听到第一段声音时,talker 还在后面继续生成。
10.4 窗口解码:25 帧新货 + 25 帧旧账
speech_decoder 解码时按固定窗口进行:
1 | |
原因是:
- 因果卷积也需要一点上下文才能出好声音。带上旧帧,新旧音频接缝处才听不出断点。
- 固定窗口对 NPU 友好(形状固定,效率高)。
- 每次只取新编号对应的音频,旧上下文只用来垫底,不重复发声。
尾部处理:talker 结束后,剩下的零头编号不够一个标准窗口,就直接一次性解完(drain),避免浪费。
11. 把整条链路串一遍
最后,用一张总表把所有东西串起来。左边是模型原理,右边是部署形态:
| 阶段 | 模型层面在做什么 | RKNN 部署时变成了什么 |
|---|---|---|
| 1. 读文字 | 文本分词器切 token | tokenizer.json(CPU) |
| 2. 查表 | 查 embedding 得到向量 | 3 张 .fp16.bin 表(CPU 查表) |
| 3. 投影 | text_projection 映射空间 | text_projection.rknn(fp16,不量化) |
| 4. 主生成 | talker 接龙,每步出第 1 路 | talker.rknn(w4a16 + GRQ + 校准数据) |
| 5. 补细节 | code_predictor 补齐 2~16 路 | code_predictor.rknn(w8a16) |
| 6. 还原声音 | 因果卷积解码器 | speech_decoder.rknn(fp16,不量化) |
| 7. 编排 | Python generate() 循环 | C++ 双线程 + KV Cache + 窗口解码 |
三句话回顾:
- Qwen3-TTS 把语音压成 16 路编号,让语言模型用接龙的方式生成声音,再实时解码成音频。
- 双轨结构(文字轨带声音轨)让它能流式输入、流式输出,首包延迟约 100 毫秒。
- RKNN 部署的精髓是分而治之:拆开模块、按敏感度差异化量化、用真实数据校准、C++ 双线程流水线,最终让 1.7B 的模型在开发板 NPU 上跑起来。
12. 附录:术语表与文件索引
12.1 术语速查
| 术语 | 解释 |
|---|---|
| Codec token | 声音压缩后的编号 |
| Codebook | 编号对应的向量字典 |
| RVQ | 一层层编码剩余误差的量化方式,得到多路编号 |
| 语义码 / 声学码 | 第 1 路决定说了什么,第 2~16 路决定怎么说 |
| MTP | Multi-Token Prediction,即 code_predictor,一步补多个编号 |
| 双轨(dual-track) | 文字向量和声音向量逐时间步相加,同步推进 |
| Prefill / Decode | 首次批量读入 / 后续逐个生成 |
| KV Cache | 缓存历史注意力中间结果,避免重复计算 |
| EOS | 结束标记,模型吐出它就停 |
| 首包延迟 | 从输入到第一段音频出来的时间 |
| w4a16 | 权重 4 位整数、激活 16 位浮点的量化方案 |
| 校准(calibration) | 用真实输入统计数值范围,确定量化参数 |
| ONNX | 模型交换格式,PyTorch 与 RKNN 之间的中转站 |
| 因果卷积 | 只依赖过去输入的卷积,支持边收边算 |
12.2 文件索引
原理相关(Qwen3-TTS-main/):
| 文件 | 看什么 |
|---|---|
qwen_tts/core/models/modeling_qwen3_tts.py |
talker、code_predictor、speaker encoder 的全部定义 |
qwen_tts/inference/qwen3_tts_model.py |
对外推理接口(声音克隆 / 声音设计 / 预设音色) |
qwen_tts/core/tokenizer_12hz/ |
12Hz 语音分词器 |
examples/test_model_12hz_base.py |
最简单的上手示例 |
技术报告(technical-report/):
| 文件 | 看什么 |
|---|---|
Qwen3-TTS_Technical_Report.md |
官方报告:架构、训练、评测全貌 |
RKNN 部署相关(rknn-Qwen3-TTS-demo/Qwen3_TTS/):
| 文件 | 看什么 |
|---|---|
README.md |
部署全流程说明与模块关系图 |
python/embeds/export_embeds.py |
三张查找表怎么导出 |
python/text_projector/ |
投影层 ONNX/RKNN 转换 |
python/talker/export_talker_onnx.py |
talker 导出(注意它把只返回最后一帧,改成了返回完整 hidden) |
python/talker/export_talker_rknn.py |
talker 量化配置:w4a16、GRQ、group32、KV Cache 2048 |
python/talker/prepare_talker_quant_data.py |
校准数据怎么生成 |
python/code_predictor/export_code_predictor_rknn.py |
w8a16 量化配置 |
python/speech_decoder/export_speech_decoder_rknn.py |
解码器不量化配置 |
cpp/talker.h |
词表大小、特殊编号、采样参数、预设音色表 |
cpp/main.cc |
双线程流水线、窗口解码、wav 写盘 |