别被厂家骗了!如何验证模型有效上下文
别被厂家骗了!如何验证模型有效上下文
玩过的模型越多,越能深切体会到上下文长度对模型推理的深远影响。一旦超出模型支持的上下文,轻则推理速度下降,重则模型左右脑互博,影响推理质量(后文 Nvidia Ruler 还会讲到这个问题,你先知道“厂家声称的上下文长度≠模型有效上下文长度”就行~),在资源紧凑寸土寸金的端侧,验证有效上下文尤其重要。
以端侧 Qwen3 VL 4B 为例,量化后上下文一般给到 4k 或者 8k 左右。想验证模型在给定上下文下的推理质量,很简单,模型部署到板子上,随便找几篇 2k、4k、8k 左右的文章推理试一试,就有底了。
但对于一些开源的 fp 模型,号称自己支持 1M 上下文,要如何确认上下文长达 1M 时,模型真能清晰思考?而不是回了一堆幻觉糊弄你?
首先,上哪找这么长的语料?其次,这么长的语料,要怎样设计问题和答案?
直接让模型总结文章主观性太强,通过瞪眼法评估模型能力?嗯~是个办法,但“能力”很难量化。
关于这个问题,业界有一套更系统的测试方法:
测试方法
大海捞针测试
构建一段极长且毫无意义的背景文本比如几万字的随机废话,或者毫不相干的散文(这就是大海)。然后,在这段长文本的不同位置,例如开头、中间10%、中间50%、结尾等,插入一句特定的关键信息,比如:“通关密码是 8392”(这就是针)。
要求模型回答“通关密码是什么”。如果模型能准确找出来,说明它在当前上下文长度下,没有忽视该位置的信息。
结果呈现方式通常是画一张热力图,横轴是上下文长度(如 4k, 8k, 32k),纵轴是信息插入的位置深度。全绿代表模型完全掌握,出现红色代表模型在特定长度或位置失忆了。
长序列困惑度测试
给模型输入一本极长的英文原著或代码库。在模型阅读的过程中,不断让它预测下一个词是什么。
随着输入的字数越来越多,如果模型的困惑度(PPL)保持稳定甚至下降,说明它能很好地利用前面的长上下文来预测后文。比如如果当字数超过 8K 时,困惑度突然飙升,就说明模型崩溃了,8K 就是它的真实上下文极限。
专业长文本基准测试集
除了大海捞针这种机械的检索,业内还开发了专门考察逻辑推理和综合理解的测试集。例如 LongBench, RULER, L-Eval。这些测试集包含多种任务:
多文档问答: 给模型几十篇不同的新闻报道,问一个需要综合多篇报道才能推导出的结论。
长代码调试: 扔进去一个包含几万行代码的完整项目,让模型找出一个深层 Bug。
会议记录提取: 给一份几万字的会议速记,要求模型精确提取某三个人的发言要点。
硬件与性能极限测试
以端侧模型为例,验证是否会撑爆预留给 kvcache 的内存空间;或者测试在可接受的 TTFT 延迟内的最大上下文长度。
常用数据集传送门
1 英文原版大海捞针:NeedleInAHaystack(NIAH)
最初让该测试方法火出圈的开源框架,把 Paul Graham 的文章当作海,在其中插入的随机数字或事实就是针。
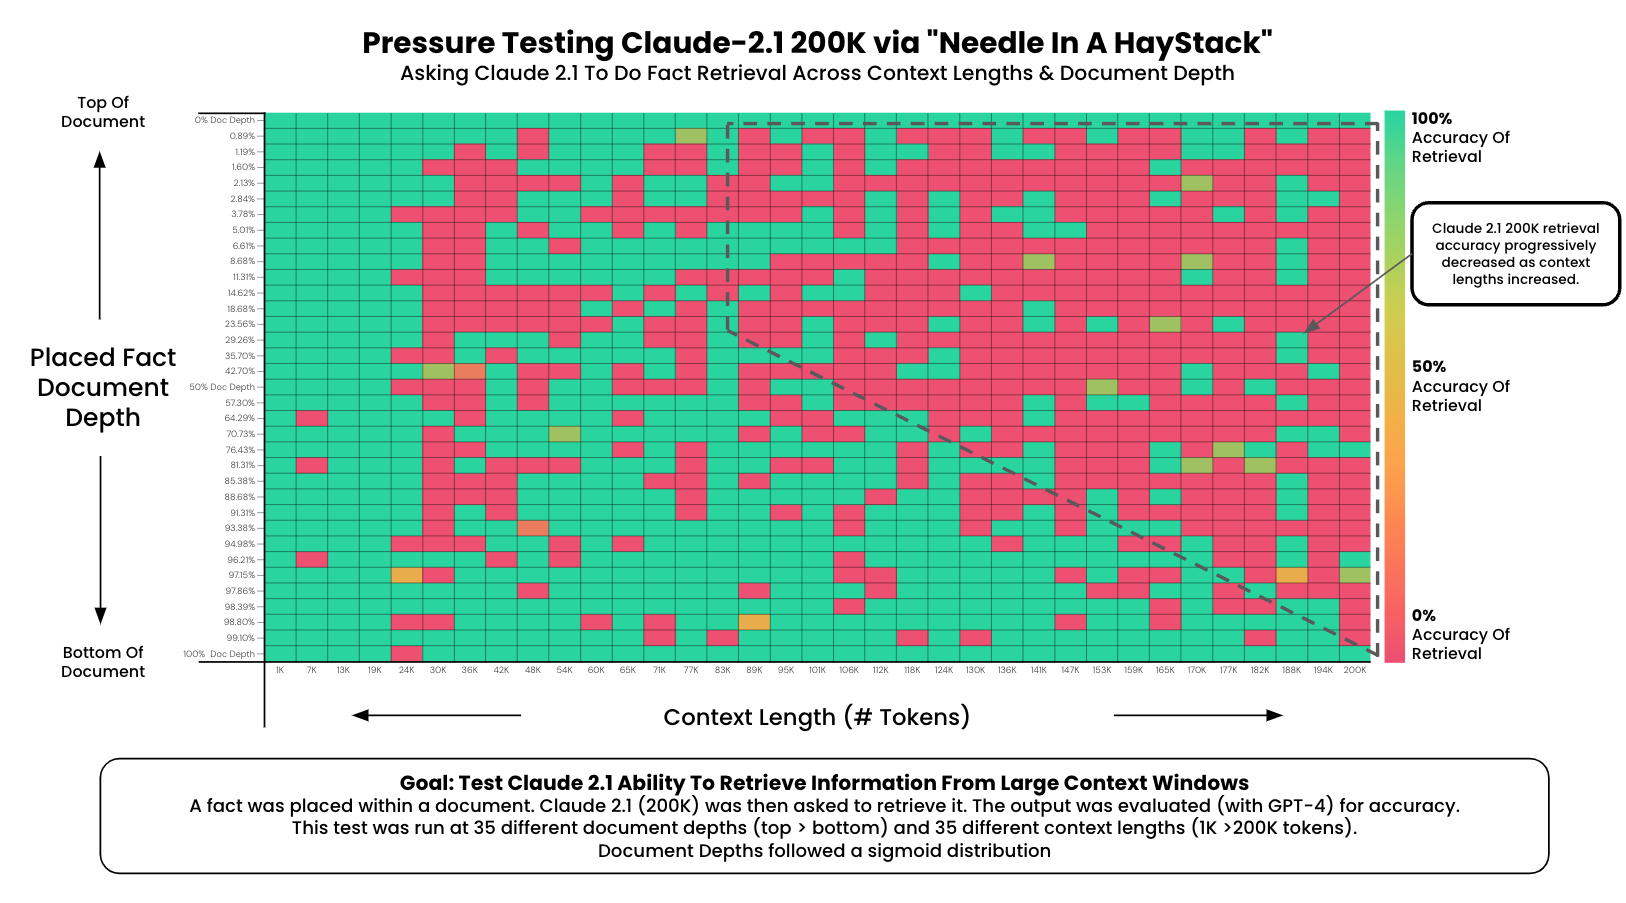
图2 是 Claude-2.1(200K)的 Needle In A HayStack 压测结果。该测试评估了模型在 1K 到 200K 不等的上下文长度以及不同的文档深度中检索特定事实的能力。图中绿色代表 100% 准确,红色代表 0% 准确,可以看出,随着上下文长度的不断增加,模型的事实检索准确率呈现出逐渐下降的趋势。
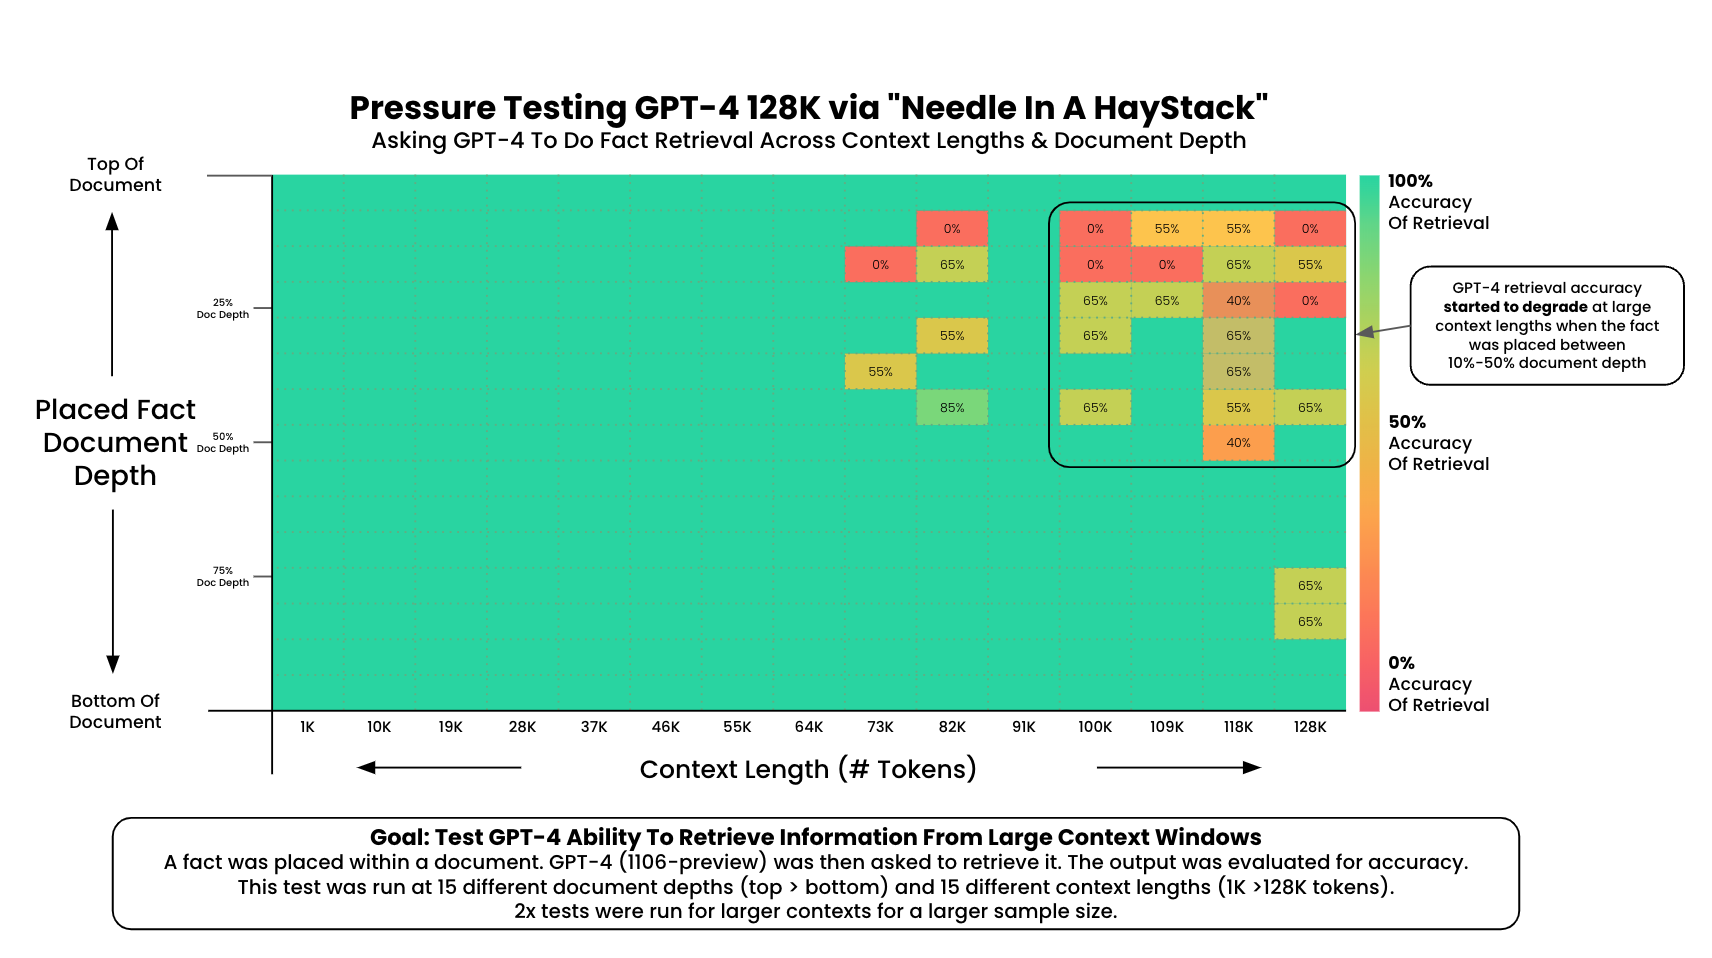
图3 是 GPT-4 128K(1106-preview 版本)的 Needle In A HayStack 压测结果。该测试评估了模型在 1K 到 128K 的上下文长度以及 15 种不同的文档深度中检索特定事实的能力。图表显示,GPT-4 在绝大多数测试条件下都保持了 100% 的高检索准确率(呈现大面积绿色)。然而,图表右上角出现了一块黄色和红色交织的区域,这表明当上下文长度非常大,并且需要检索的事实被放置在文档 10% 到 50% 的深度区间时,GPT-4 的检索准确率开始出现明显下降。
2 中文及多语言强化版大海捞针:NeedleBench
这是目前国内中文测试最常引用的框架,旨在评估大型语言模型在处理和理解长文档方面的能力。由上海人工智能实验室(OpenCompass)开源。它包括一系列测试场景,用于评估模型在长文本信息提取和推理方面的能力。数据集被构造为支持诸如单针检索、多针推理和祖先追踪挑战之类的任务。
Hugging Face: opencompass/NeedleBench
GitHub: open-compass/opencompass
测试逻辑主要位于
configs/datasets/needlebench_v2/目录下
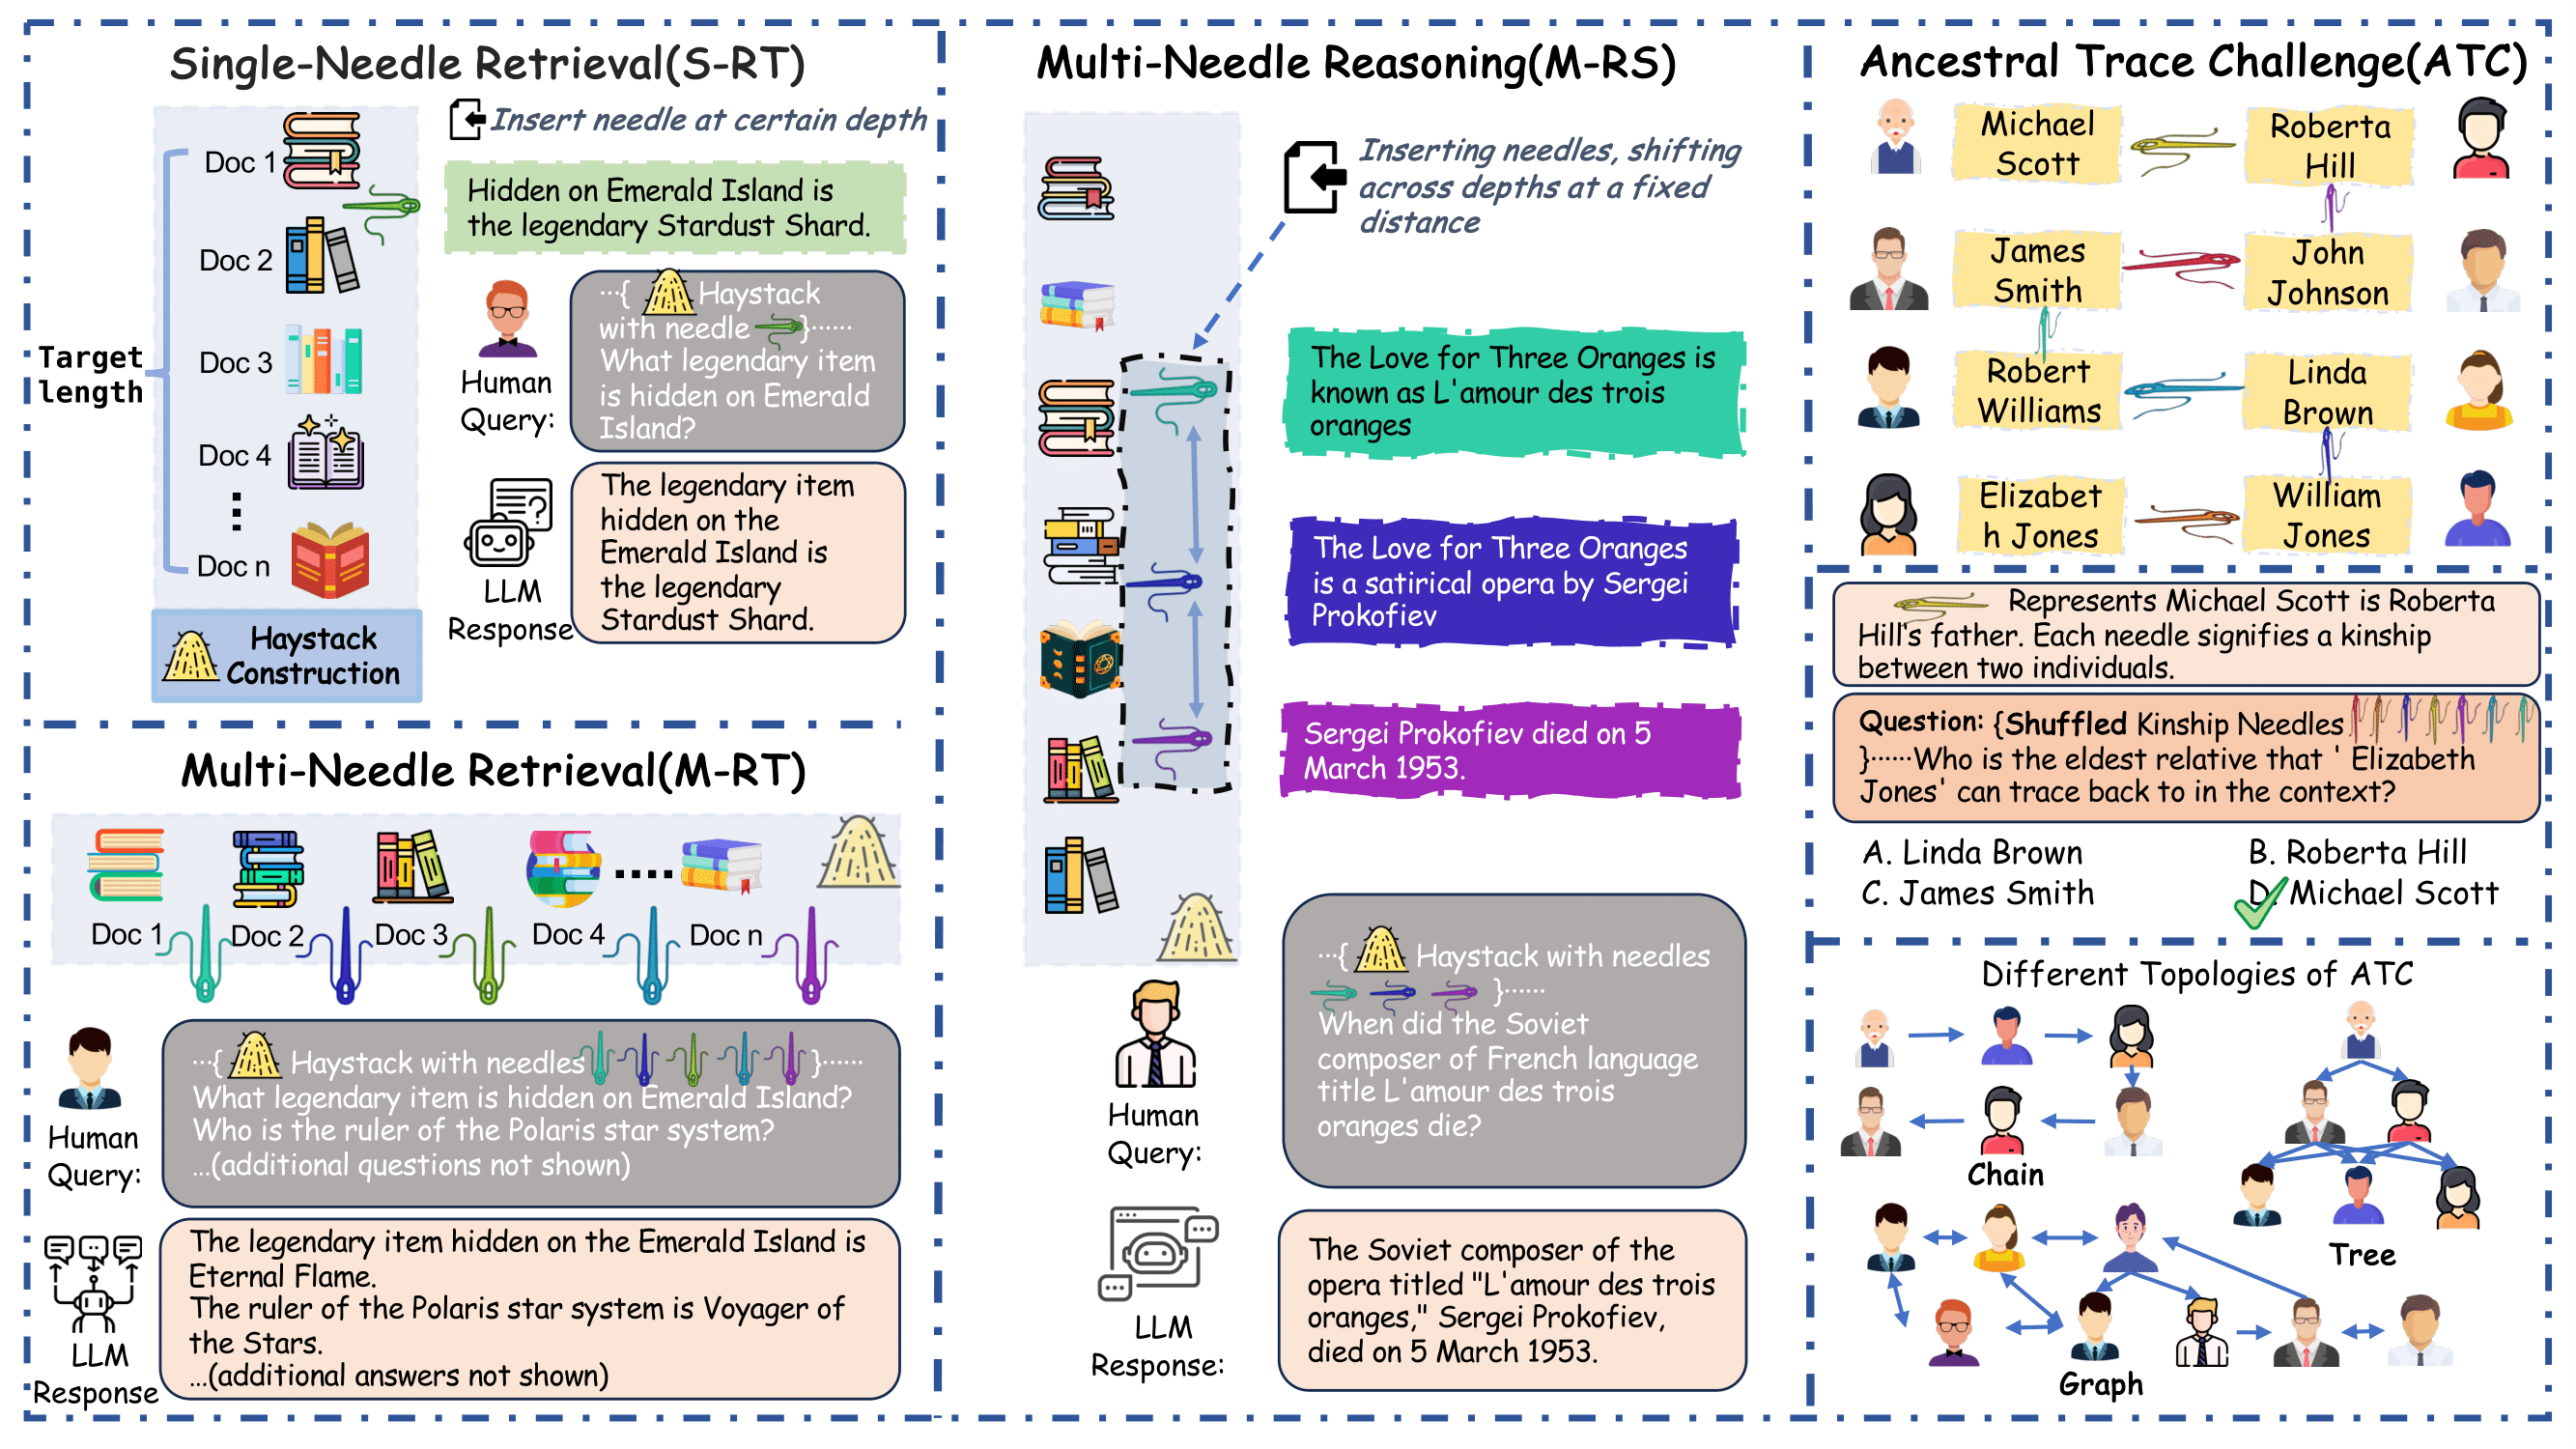
图 4 展示的四种任务:
单针检索 (S-RT):从长文本中提取单一关键信息。
将单一目标信息(如翡翠岛上隐藏的物品)插入长文本的特定深度,要求模型直接定位并输出该答案。
多针检索 (M-RT):从长文本中检索多条相关信息。
在长文本的不同文档中插入多个独立的目标信息,要求模型针对包含多个问题的查询,同时检索出所有对应的答案。
多针推理 (M-RS):提取并利用多条关键信息进行综合理解。
要求模型跨越不同文本深度提取多条分散但相关的信息(如从歌剧的法语别名关联到其作曲家,再关联到该作曲家的死亡时间),并进行逻辑拼接以推理出最终答案。
祖先追踪挑战 (ATC):处理真实长文本中的多层逻辑挑战。
在文本中插入大量打乱的亲属关系声明,并通过链状、树状或图状等不同的拓扑结构增加难度,要求模型基于碎片化线索追踪家谱关系并回答问题。
3 进阶测试:NVIDIA/RULER
英伟达推出的进阶版测试,专门用来打假那些只会做基础大海捞针、却缺乏长上下文真实理解能力的模型。包含了条件检索、多针混合等复杂场景。
这篇由 NVIDIA 团队发表于 COLM 2024 的论文 RULER: What’s the Real Context Size of Your Long-Context Language Models?,直击了当时长文本大语言模型(Long-Context LLMs)评测中的一个痛点:模型宣称的上下文窗口,究竟有多少是真实可用的?
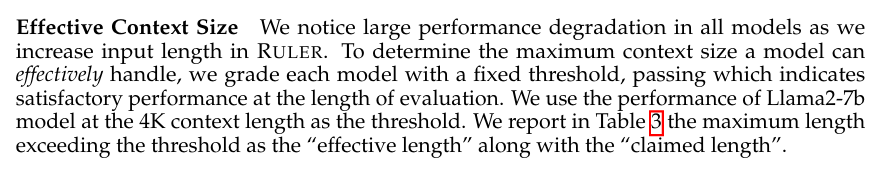
有效上下文长度 我们注意到所有模型在 RULER 中随着输入长度的增加都出现了大幅性能退化。为了确定模型能够有效处理的最大上下文大小,我们使用固定阈值对每个模型进行评分,通过该阈值表示在评估长度下具有令人满意的性能。我们使用 Llama2-7b 模型在 4K 上下文长度下的性能作为阈值。我们在表 3 中报告了超过阈值的最大长度作为 “实际有效长度(Effective Length)” 以及 “声称长度(Claimed Length)”。
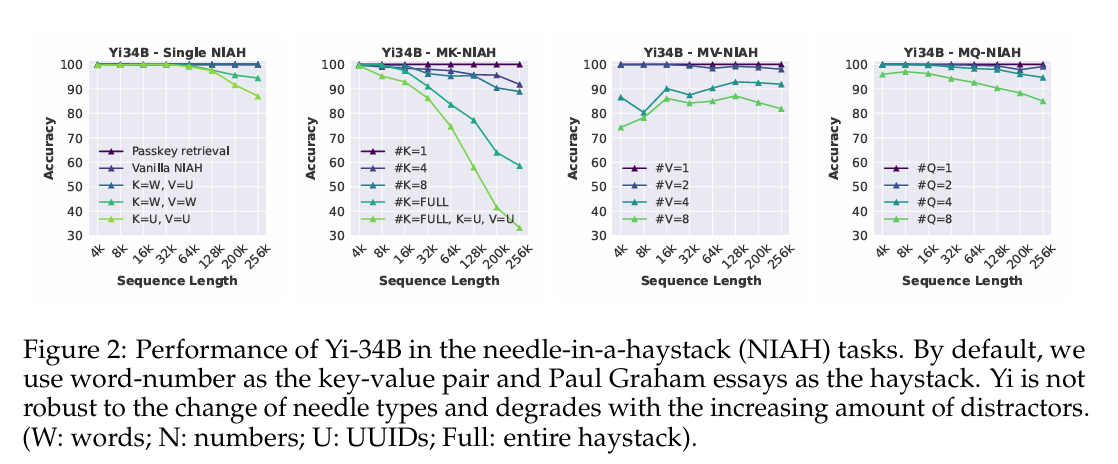
用实验数据揭示了为什么单针 NIAH 存在巨大欺骗性
实验对比了 Yi-34B(宣称支持 200K 上下文)在 Vanilla S-NIAH 与增加复杂度(Multi-keys、Multi-values、Multi-queries)后的表现曲线。
在基础单针 NIAH 下,Yi-34B 几乎在全长度上都接近 100%;但一旦加入干扰键(Multi-keys)或要求召回多个值(Multi-values),当上下文长度推高至 32K、64K 时,准确率迅速发生断崖式下跌。这张图直接证明了引入更复杂合成任务的必要性。
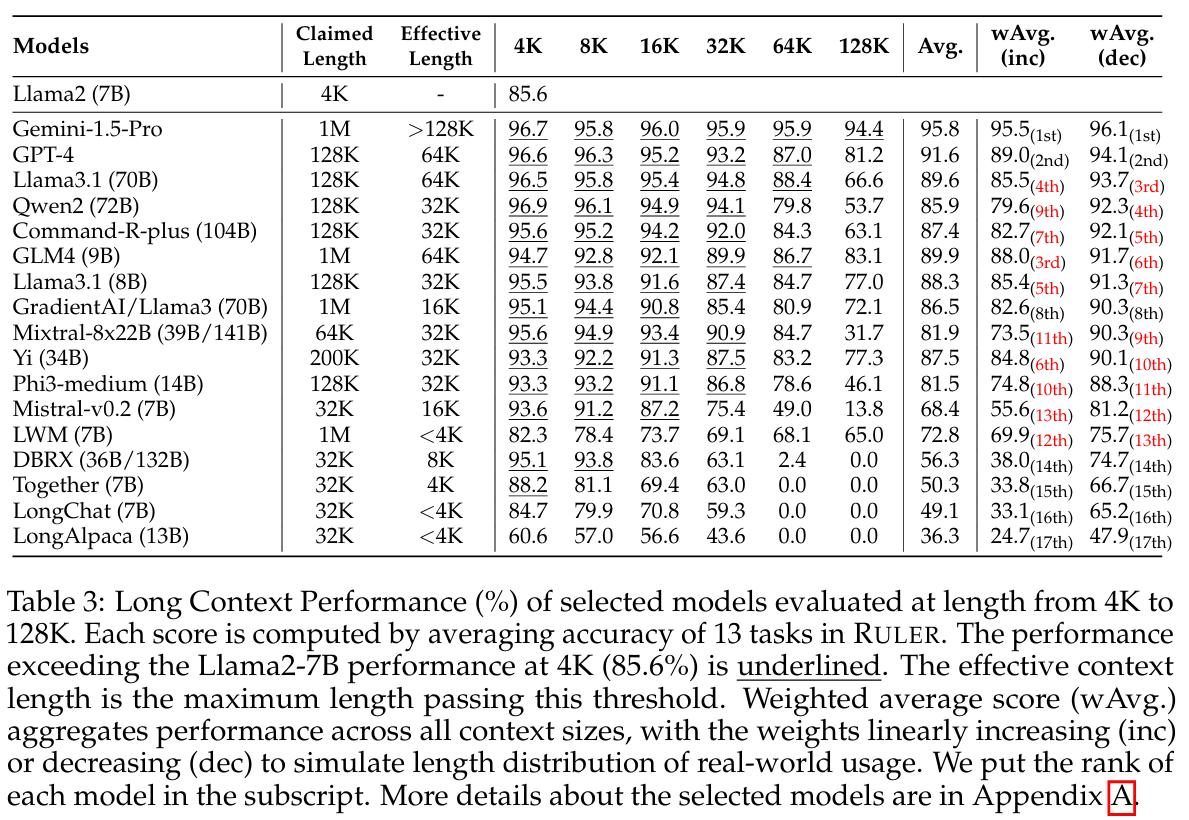
这张表直接回答了论文标题的核心问题(What’s the Real Context Size?),列出了主流长文本模型(包括 Llama 3/3.1 系列、Yi-34B、Command-R/R+、Mixtral、Qwen 系列、GPT-4、Gemini 等)在 4K、8K、16K、32K、64K、128K 等不同长度下的综合得分。展示了从 4K 扩展到 128K 时,绝大多数模型准确率从 90%+ 逐步跌破 80%、甚至暴跌至 20%~40% 的全过程,戳破了“宣称支持多少 K,就能用好多少 K”的泡沫。
这波打假好评~
4 综合长文本理解基准
除了单纯的大海捞针,如果你想系统性测试端侧模型在真实长篇新闻、几十万行代码、超长会议记录中的表现,清华大学开源的 LongBench 是目前最权威的中英双语测试集之一。
- Hugging Face: THUDM/LongBench
- GitHub: THUDM/LongBench
- 论文:LongBench: A Bilingual, Multitask Benchmark for Long Context Understanding
简而言之,验证显存、注意力机制,跑 NeedleBench 单针就够了;想看模型理解能力,再跑 RULER、LongBench。