用 print(model) 认识 Qwen3-TTS
用 print(model) 认识 Qwen3-TTS
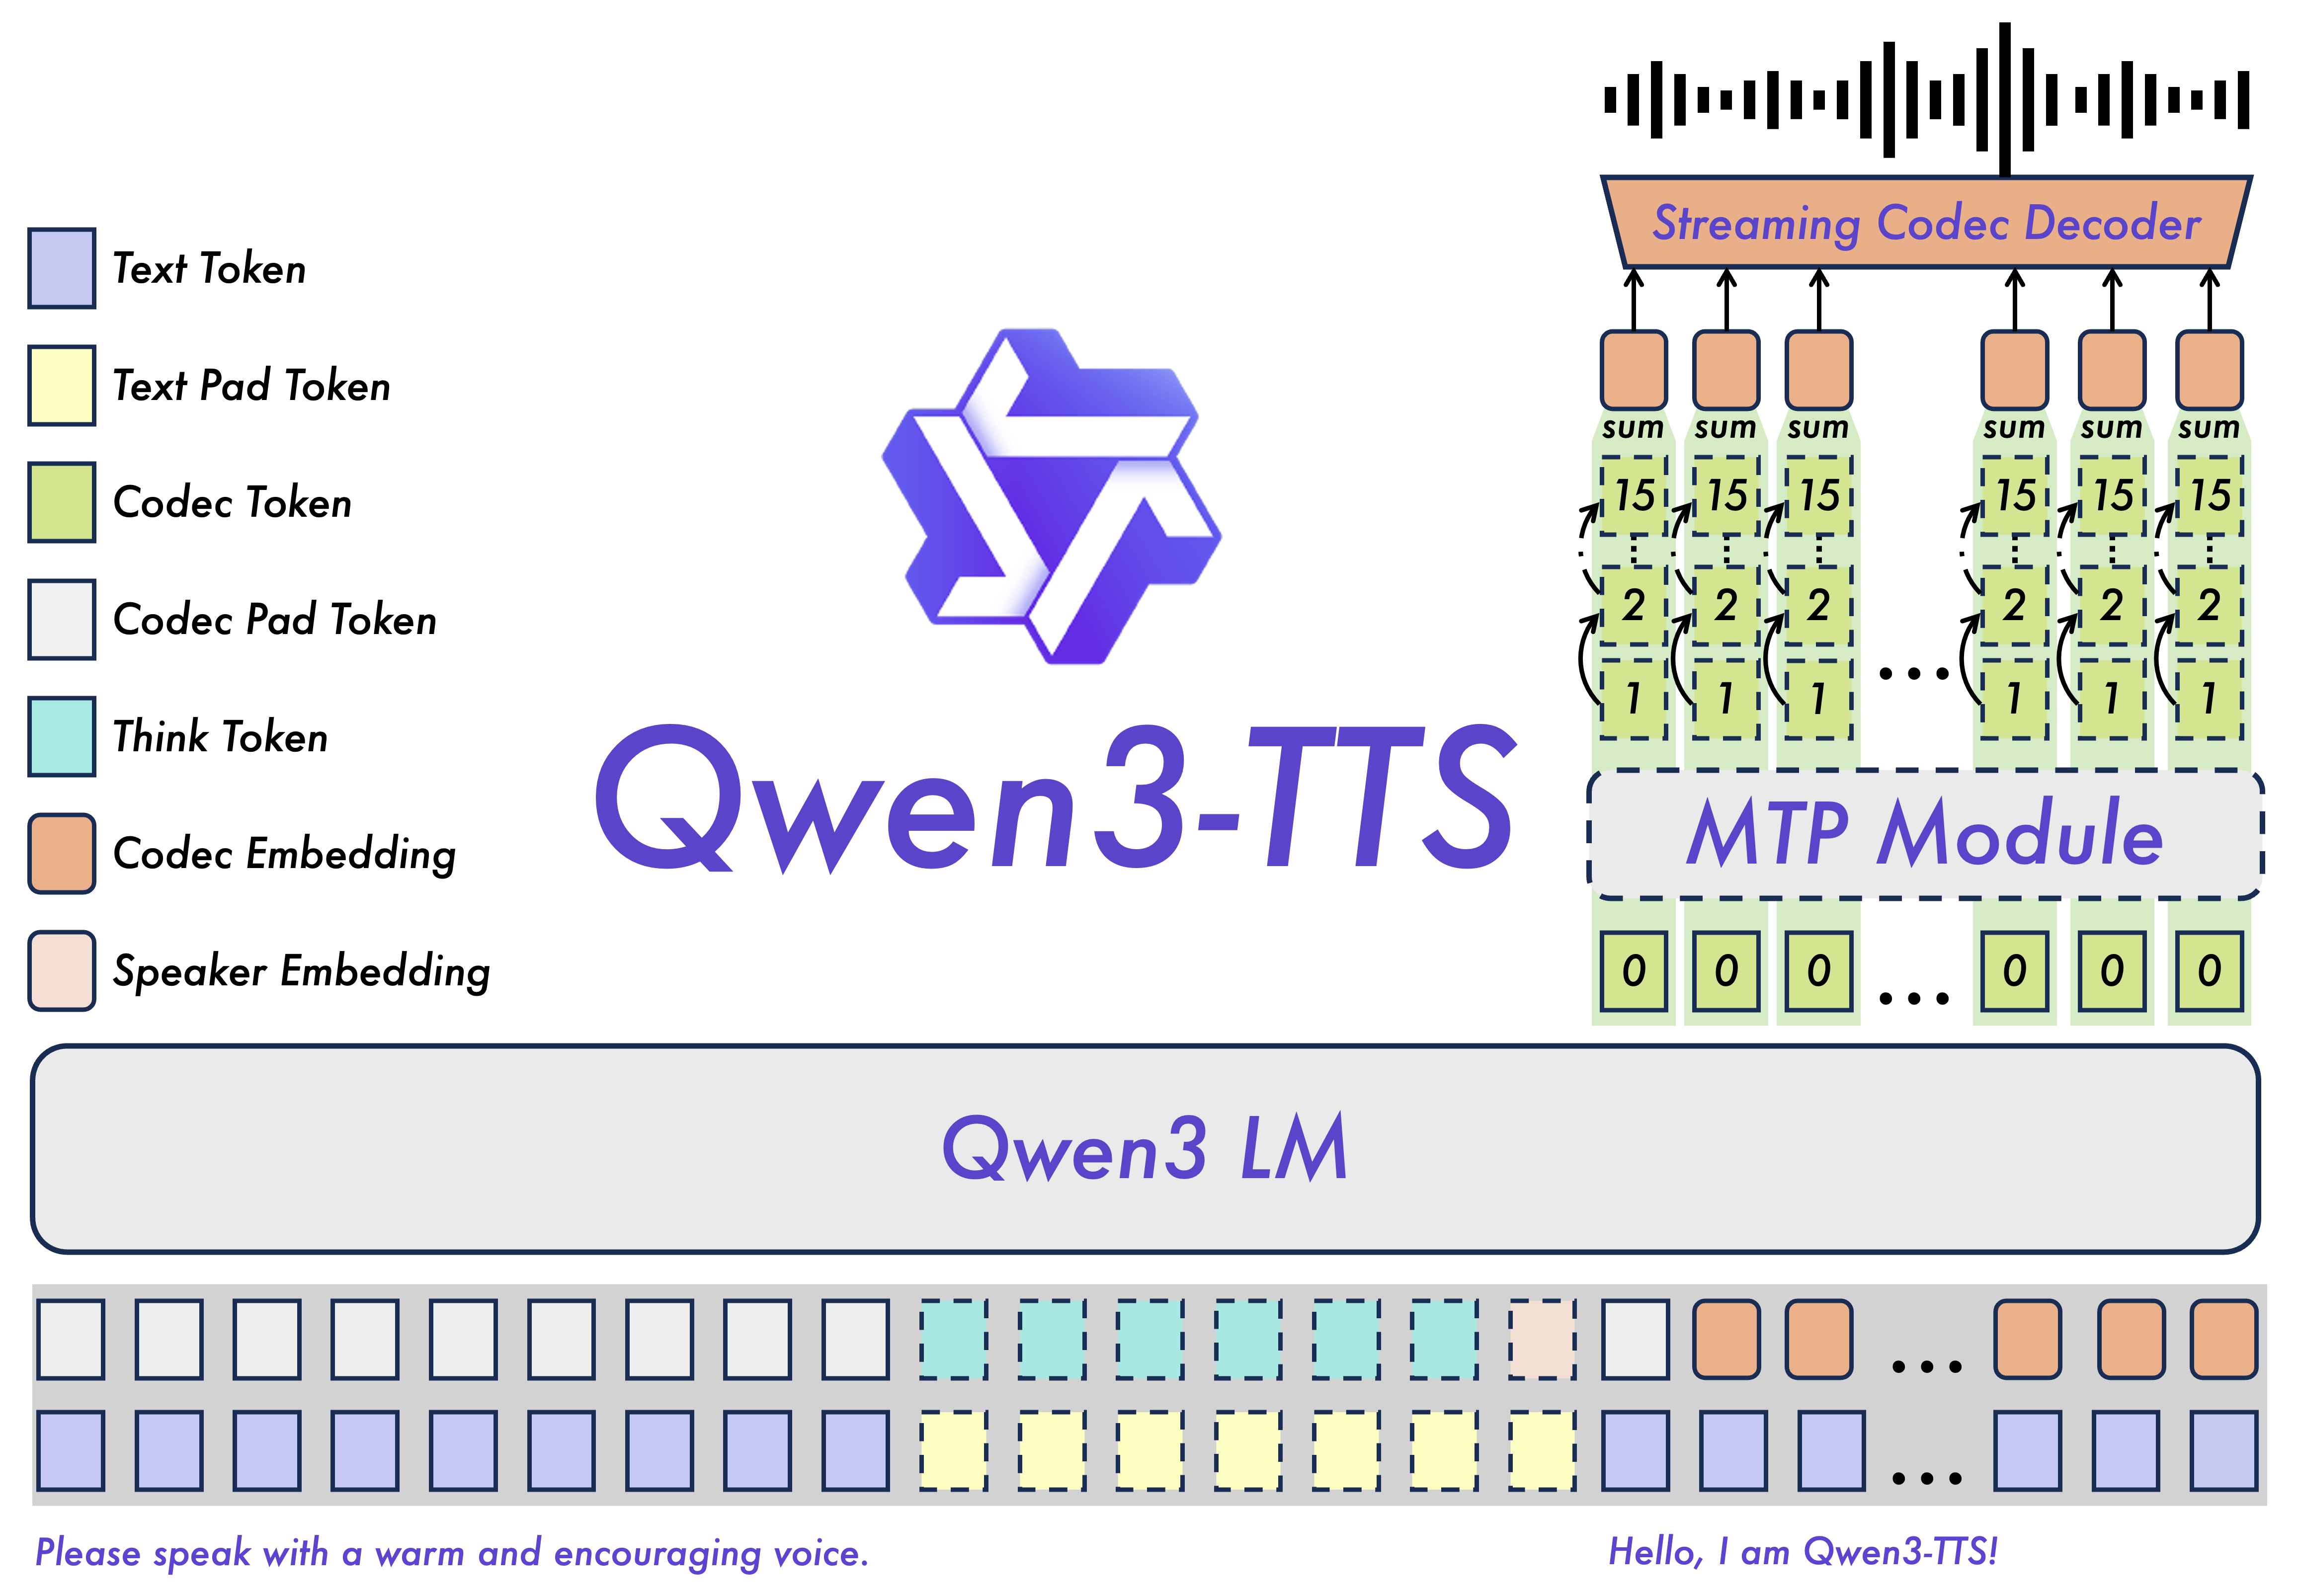
浏览一个模型架构最快捷的方法是什么? print(model)!
这篇文章就以 Qwen3-TTS(12Hz-0.6B-Base 版本)的 print(model) 输出为线索,拆解模型架构。文章里贴了两段完整的打印结果,一段是 TTS 主模型,一段是神经音频编解码器(Tokenizer)。每段后面都跟着逐层注释和结构分析。
先准备打印环境。
打印方法
1 | |
torch_model 是 TTS 主模型(文本到 codec token),codec_model 是神经音频编解码器(codec token 到 PCM 波形)。两个模型各司其职,后面会分别展开。
Qwen3TTSForConditionalGeneration
1 | |
注释
1 | |
总览:两大组件
Qwen3TTSForConditionalGeneration 这个名字沿用自 HuggingFace Transformers 的命名体系,和 BartForConditionalGeneration、T5ForConditionalGeneration 一个套路。”Conditional”指的是生成过程依赖外部条件(文本、音色),不是无条件生成。
它包含两个顶层组件:
1 | |
数据流是这样的:
1 | |
这些 codec token 随后被送入下一节讲的 Tokenizer 解码器,还原成 PCM 波形。
Talker:28 层 Transformer 解码器
Talker 是模型的主体,一个标准的 Transformer decoder-only 架构。打印结果里能看到 28 个完全相同结构的 Qwen3TTSTalkerDecoderLayer 堆叠在一起,每层做两件事:自注意力(self_attn)和前馈网络(mlp)。
隐藏维度与 GQA 注意力。 每层的隐藏维度是 1024,但注意力的投影维度出现了不对称:
1 | |
Q 的维度是 K 的两倍,这是分组查询注意力(Grouped-Query Attention, GQA)。按 head_dim=128 算:Q 有 16 个注意力头,K 和 V 各 8 个头。每 2 个 Q 头共享 1 组 KV 头。GQA 的好处是在不大模型量的前提下增加注意力的表达能力,同时减少 KV Cache 的内存占用,对自回归生成场景尤其有用。
QK-Norm。 注意力模块里还有 q_norm 和 k_norm,维度都是 128(即单个 head 的维度)。这是对每个注意力头的 Q 和 K 做 RMSNorm 归一化。深层 Transformer 训练时,Q 和 K 的点积容易出现数值漂移(logits 越训越大),QK-Norm 把它们的模长限制住,稳定训练过程。这是从 Qwen2 系列延续下来的设计。
SwiGLU 前馈网络。 MLP 的写法是典型的 SwiGLU 变体:
1 | |
计算过程是 down_proj(SiLU(gate_proj(x)) * up_proj(x))。gate 分支过 SiLU 激活后与 up 分支逐元素相乘,再投影回原始维度。中间维度 3072 是隐藏维度 1024 的 3 倍,这和 LLaMA/Qwen 系列的做法一致。相比传统的两层 MLP(fc1 → ReLU → fc2),SwiGLU 的门控机制让网络能选择性地让信息通过,在同等参数量下表现更好。
双 Embedding 设计。 Talker 有两套独立的词嵌入:
| 嵌入层 | 词表大小 | 维度 | 用途 |
|---|---|---|---|
| text_embedding | 151936 | 2048 | 文本 token → 文字向量 |
| codec_embedding | 3072 | 1024 | 第 1 路 codec token → 声音向量 |
两套嵌入的维度不一样:文本侧是 2048,声音侧是 1024。这并不矛盾,因为文本向量会经过 text_projection 投影到 1024 维,再和声音向量相加。Qwen3 的标准文本词表有 151936 个 token,每个 token 对应一个 2048 维向量。光是这张文本嵌入表就占了约 311M 参数(151936 × 2048 × 2 bytes)。
这就是所谓的”双轨”(dual-track)设计:文字轨和声音轨各自的向量在每个时间步相加,一起送入 Transformer。文字轨决定”说什么”,声音轨决定”怎么说”。两条轨同步推进,文字可以流式输入,不用等全句到齐就能开始出声。
Text Projection:维度投影
1 | |
text_embedding 输出的向量是 2048 维,而 Talker 的隐藏层是 1024 维。text_projection 就是一个两层 MLP,负责把文本向量从 2048 压到 1024,让它能和 codec_embedding 的输出在同一维度上相加。
为什么不在 text_embedding 里直接输出 1024 维?因为 Qwen3 的文本词表是通用的,和其他 Qwen3 模型共享同一套嵌入权重。TTS 模型拿过来用,再额外加一个投影层适配自己的隐藏维度。这种做法复用了预训练好的文本表示能力,代价只是多了一个小型 MLP。
Codec Head:语义码预测
1 | |
Talker 主干 Transformer 的输出经过最终的 RMSNorm 后,由 codec_head 投影到 3072 维。3072 就是 codec 的词表大小,对应第一路(语义层)codec token 的所有可能取值。模型在这 3072 个 logits 上做 softmax 再采样,选出下一个语义码 token。
3072 比 Tokenizer 码本的 2048 多出 1024 个位置。多出来的部分通常留给特殊 token(EOS 结束标记、padding 等)。
Code Predictor:15 路声学码补齐
Talker 每步只预测第 1 路语义码。剩下的第 2~16 路声学码,交给 code_predictor 来补齐。
1 | |
几个值得注意的地方:
5 层 vs 28 层。 code_predictor 的结构和 Talker 完全相同(同样的注意力、MLP、归一化),但只有 5 层。原因很直接:预测声学细节不需要 28 层那么深的理解力。语义码已经决定了”说什么”,code_predictor 只需要根据语义码和 Talker 的中间状态,补上音色、韵律等声学细节。任务简单,网络就小。
15 张嵌入表 + 15 个预测头。 code_predictor 自回归地预测 15 路声学码:先预测第 2 路,再预测第 3 路,直到第 16 路。每一路有自己的嵌入表(Embedding(2048, 1024))和预测头(Linear(1024, 2048))。预测第 N 路时,把前面已预测的 1N-1 路的嵌入向量累加起来作为输入。2048 是每路码本的大小(02047),对应 Tokenizer 里每层 RVQ 的 codebook 条目数。
small_to_mtp_projection 是 Identity。 这说明 code_predictor 的隐藏维度和 Talker 完全一致(都是 1024),不需要额外的维度转换。code_predictor 可以直接接收 Talker 的中间隐状态(past_hidden)作为上下文,零开销对接。
源码里 code_predictor 也叫 MTP(Multi-Token Prediction),一步预测多个 token,只是这些 token 分属不同的 RVQ 层级而非不同的时间步。
Speaker Encoder:ECAPA-TDNN 音色提取
Speaker Encoder 和 Talker 完全独立,不参与自回归生成循环。它的任务只有一个:从一段 3 秒左右的参考音频中,提取一个固定维度的音色向量。
打印结果里的结构是经典的 ECAPA-TDNN(Emphasized Channel Attention and Propagation Aggregation in TDNN)架构,这是说话人识别领域的主流方案。逐块来看:
Block 0:入口 TDNN。 输入是 128 维的梅尔频谱特征(每帧 128 个 mel 系数),经过一个 kernel_size=5 的 1D 卷积扩展到 512 维。5 个采样点的卷积核能捕获相邻 5 帧的上下文。
Block 1~3:SE-Res2Net 核心块。 三个块结构相同,区别在膨胀率(dilation):2、3、4。
每个块内部的流程:
1 | |
Res2Net 的思路是把 512 个通道分成 8 组(每组 64 通道),第 1 组的输出会流入第 2 组的卷积,第 2 组流入第 3 组……形成分层残差连接。这种结构在同样的参数量下增大了有效感受野,能同时捕获细粒度和粗粒度的声学特征。
SE Block 的作用是让网络学会”哪些通道更重要”。比如某些通道可能对基频敏感,另一些对共振峰敏感,SE 机制让网络动态调整各通道的权重。
三个块的膨胀率分别为 2、3、4,感受野逐块增大。dilation=2 时,3x3 卷积覆盖 5 帧;dilation=4 时覆盖 9 帧。不同尺度的感受野组合起来,既能捕捉局部的声纹细节,也能感知稍长范围的声音特征。
MFA:多层特征聚合。 mfa 层的输入维度是 1536 = 512 × 3,说明它把 Block 1、2、3 的输出在通道维度上拼接起来,再用 1x1 卷积融合。不同层级的特征各有侧重(浅层捕捉音色细节,深层捕捉抽象模式),拼接后信息更完整。
ASP:注意力统计池化。 音频长度不固定,但模型需要一个固定维度的向量。AttentiveStatisticsPooling 的做法是:
- 用一组可学习的注意力权重,对每一帧打分
- 按权重计算所有帧的加权均值和加权标准差
- 均值和标准差拼接,得到定长输出
打印结果里 ASP 的输入维度是 4608 = 1536 × 3,对应均值(1536)、标准差(1536)、以及 MFA 输出(1536)的拼接。输出经过 fc 层(3072 → 1024)压缩到 1024 维,这就是最终的 Speaker Embedding。
1024 维的 Speaker Embedding 会被拼接在 Talker 输入序列的最前面,作为”音色提示”。Talker 在生成过程中通过注意力机制随时参考这个向量,从而克隆出目标说话人的音色。
维度流转小结
把上面所有组件串起来,一个完整时间步的数据流是:
1 | |
整个模型叫 0.6B,参数量主要来自三块:text_embedding 约 311M,28 层 Transformer 约 250M,其余组件加起来不到 50M。
Qwen3TTSTokenizerV2Model
Tokenizer 负责把 PCM 波形压缩成离散的 codec token(编码),也负责把 codec token 还原回 PCM 波形(解码)。Talker 生成的那些编号,最终都要经过 Tokenizer 的解码器才能变成能播放的声音。
打印结果较长,为节省篇幅,这里省略了 DecoderBlock 内部重复的残差单元细节(每个 Block 的 3 个 ResidualUnit 结构一致,仅 dilation 分别为 1、3、9):
1 | |
注释
1 | |
总览:编码器与解码器
Tokenizer 是一个标准的编码器-解码器(codec)架构:
1 | |
和 Talker 相比,Tokenizer 的设计思路完全不同。Talker 是语言模型,靠注意力和自回归生成;Tokenizer 是信号处理模型,靠卷积和量化做波形压缩。两者的协作方式是:Tokenizer 先训练好,提供”声音到编号”和”编号到声音”的能力;Talker 在此基础上学会”根据文本预测编号”。
编码器:Mimi 架构的逐级压缩
编码器基于 Mimi(Kyutai 的神经音频编解码器)架构。MimiEncoder 的 layers 是一系列卷积层和残差块的交替堆叠。关键在下采样卷积的 stride:
| 层序号 | 操作 | Stride | 累计下采样倍率 | 通道数变化 |
|---|---|---|---|---|
| 0 | Conv1d, kernel=7 | 1 | 1x | 1 → 64 |
| 1 | ResnetBlock | 1 | 1x | 64 → 64 |
| 3 | Conv1d, kernel=8 | 4 | 4x | 64 → 128 |
| 4 | ResnetBlock | 1 | 4x | 128 → 128 |
| 6 | Conv1d, kernel=10 | 5 | 20x | 128 → 256 |
| 7 | ResnetBlock | 1 | 20x | 256 → 256 |
| 9 | Conv1d, kernel=12 | 6 | 120x | 256 → 512 |
| 10 | ResnetBlock | 1 | 120x | 512 → 512 |
| 12 | Conv1d, kernel=16 | 8 | 960x | 512 → 1024 |
| 14 | Conv1d, kernel=3 | 1 | 960x | 1024 → 512 |
四个下采样卷积的 stride 分别是 4、5、6、8,累乘得到 960 倍下采样。24000 Hz 的音频经过这 960 倍压缩,变成 25 Hz 的潜在特征序列(24000 / 960 = 25)。每个 ResnetBlock 结构一致:ELU → 3x3 卷积(通道减半)→ ELU → 1x1 卷积(通道恢复),加上残差连接(shortcut=Identity)。
编码器卷积之后还有两个组件:
encoder_transformer:8 层 Transformer。 卷积只能看到局部上下文(受限于卷积核大小),8 层 Transformer 补充了全局建模能力。这一段的 Transformer 用的是标准的 MHA(Multi-Head Attention),Q/K/V 维度都是 512,没有 GQA。MLP 用的是传统两层结构(fc1 → GELU → fc2),中间维度 2048。还配备了 LayerScale,对注意力和 MLP 的输出乘以一个可学习的缩放系数,帮助深层 Transformer 稳定训练。
downsample:额外 2 倍下采样。 Conv1d(512, 512, kernel=4, stride=2) 把序列长度减半。结合前面的 960 倍,总下采样倍率达到 1920 倍。24000 / 1920 = 12.5 Hz,正好对应 12Hz 版本的帧率。
Split RVQ:语义与声学分离
编码器输出的连续特征经过 MimiSplitResidualVectorQuantizer 被离散化。这个量化器被拆成两部分:
1 | |
语义层(1 层)。 只用一层 VQ(Vector Quantization),在 512 维空间中查找最近的码本条目。这一层捕获的是最核心的语义信息:”这帧声音说的是什么内容”。语义码就是 Talker 自回归预测的那个 token。
声学层(31 层)。 31 层级联的残差向量量化。第 1 层量化语义层的残差,第 2 层量化第 1 层的残差……逐层逼近,每一层补充更细的声学细节(音色、气息感、情感色彩等)。
编码端总共产生 1 + 31 = 32 路 codec token。但解码端只用 1 + 15 = 16 路。这并非 bug:编码端用 32 层做高精度量化来训练出好的潜在空间,解码端只需要前 16 路就能还原出足够好的音频。Talker 和 code_predictor 也只生成 16 路,剩下的 16 路声学码在推理时不会被使用。
每层 RVQ 的码本大小是 2048(每个 codebook 有 2048 个条目),所以每路 token 的取值范围是 0~2047。这和 Talker 里 code_predictor 的 Embedding(2048, 1024) 以及 Linear(1024, 2048) 完全对应。
量化前后的 input_proj 和 output_proj 是 1x1 卷积,把特征从 512 维投影到 256 维做量化,再投影回 512 维。降维量化减少了码本的搜索空间,也降低了计算开销。
解码器:从编号回到波形
解码器的任务是把 16 路离散 codec token 还原成 24kHz 的单声道 PCM 波形。它的结构可以分为四段:pre_transformer → quantizer 反量化 → 上采样 → 波形解码。
pre_transformer:8 层 Transformer。 和编码端的 Transformer 对称,但有两个区别:
- 注意力维度做了扩展:q_proj 输出 1024 维,k_proj/v_proj 也输出 1024 维,o_proj 从 1024 压回 512。Q/K/V 的头数一致,是标准 MHA。
- MLP 用了 SwiGLU(gate/up/down 三门控),和 Talker 一致,而不是编码端的传统 fc1/fc2 结构。
解码端还配备了 input_proj: Linear(1024 → 512) 和 output_proj: Linear(512 → 1024)。这是因为反量化后的特征维度是 1024(16 路码本嵌入累加),需要先压到 512 送入 Transformer,处理完再扩回 1024。
quantizer(解码端):16 路反量化。 解码端的 SplitResidualVectorQuantizer 和编码端对应,但只有 1 + 15 = 16 层:
1 | |
16 路 token 各自在对应的码本中查找嵌入向量,累加起来得到近似的连续特征。
upsample:4 倍上采样。 两个上采样阶段,每个阶段包含:
ConvTranspose1d(kernel=2, stride=2):转置卷积,时间维度放大 2 倍ConvNeXtBlock:深度可分离卷积(groups=1024,每个通道独立卷积)+ LayerNorm + 逐点卷积(1024 → 4096 → 1024),做特征平滑
两个阶段总共 4 倍上采样。结合后面波形解码器的上采样倍率(8 x 5 x 4 x 3 = 480),总上采样倍率 = 4 x 480 = 1920。12.5 Hz x 1920 = 24000 Hz,正好还原到音频采样率。
波形解码器:4 个 DecoderBlock + 输出层。 这是最终生成波形的部分。4 个 DecoderBlock 的结构完全对称:
1 | |
每个 DecoderBlock 的上采样倍率分别是 8、5、4、3:
| Block | 转置卷积 | 上采样倍率 | 通道变化 |
|---|---|---|---|
| 1 | kernel=16, stride=8 | 8x | 1536 → 768 |
| 2 | kernel=10, stride=5 | 5x | 768 → 384 |
| 3 | kernel=8, stride=4 | 4x | 384 → 192 |
| 4 | kernel=6, stride=3 | 3x | 192 → 96 |
每个 Block 后面跟 3 个残差单元,膨胀率分别是 1、3、9。不同膨胀率带来不同的感受野:dilation=1 关注相邻采样点的局部细节,dilation=9 覆盖更广的范围。这种多尺度感受野的组合让解码器既能生成平滑的波形包络,也能填充高频细节。
SnakeBeta 激活。 整个解码器使用 SnakeBeta 而不是 ReLU 或 GELU。SnakeBeta 的公式是 (x + \frac{1}{\beta} \sin^2(\alpha x)),其中 (\alpha) 和 (\beta) 是可学习参数。这个激活函数天然具有周期性,适合生成音频波形这种周期性信号。ReLU 会把负值直接截断,丢失波形的负半周期信息;SnakeBeta 保留了这种振荡特性。
因果卷积(CausalConv)。 解码器里大量使用因果卷积(名字里带 Causal 的组件)。因果卷积在计算当前时刻的输出时只看过去和当前的输入,不依赖未来帧。这个特性使得解码器可以在收到 codec token 的同时就开始解码,不用等整段序列生成完毕。流式低延迟就是靠这个实现的。
最终输出层是 Conv1d(96, 1, kernel=7),把 96 维特征映射到 1 个通道,即单声道 PCM 波形。
从打印结果读出的设计逻辑
回过头来审视整张打印结果,几个设计决策值得记录。
Talker 和 Code Predictor 的分工。 让一个大模型(28 层)只预测语义码,让一个小模型(5 层)补齐声学码,这种拆分降低了自回归序列的长度(每步只需生成 1 个 token 而非 16 个),也让两个模型各自的训练目标更聚焦。代价是 code_predictor 每帧要跑 15 步自回归,但 5 层的小模型单步很快。
Tokenizer 编码端 32 层 RVQ、解码端只用 16 层。 这是一种训练策略:编码端用高精度量化(32 层)确保潜在空间的信息丰富度,解码端用低精度(16 层)降低推理开销。Talker 只需要学习生成 16 路,负担更小。
编码器和解码器用了不同风格的 Transformer。 编码端用传统 MHA + GELU MLP,解码端用 SwiGLU MLP + RMSNorm。这可能是因为解码端的设计更晚定型,借鉴了 LLM 领域的新经验(SwiGLU 和 RMSNorm 在语言模型上的效果更好),而编码端沿用了 Mimi 原始架构。
Speaker Encoder 独立于生成循环。 它只在推理开始时运行一次,把参考音频变成一个固定的音色向量。之后的自回归生成过程中,Speaker Encoder 不再参与计算。这意味着声音克隆的开销很低,只在首帧有一次性的计算成本。
整体模型量级的分配。 0.6B 版本的参数量大头在 text_embedding(约 311M)和 Talker Transformer(约 250M)。Tokenizer 的参数量相对较小(卷积为主,参数量远低于同等层数的 Transformer)。Speaker Encoder 更小,大约只有几百万参数。这种分配反映了一个事实:TTS 模型的核心能力在于语言理解(文本到语义码的映射),声学重建和波形合成的参数量反而不大。