截至 20260923,有关 Jev 的一切
截至 20260923,有关 Jev 的一切
本文整理自 TypeSafe 官网与官方文档、创始人的公开帖文与演讲,以及概率校准领域的通用数学推导。
喵喵天:对 Jev 的理解
最近这个叫 Jev 的模型被吹起来了,OpenAI 里面有个研究 RLHF 的哥们自立门户,提出了 RLCD,面向校准决策的强化学习,舍弃模型的补全能力,只要模型给出概率,换取超高的响应速度,并且也更适合工程化。
我接触到这个模型,是在端侧 claw 项目中,需要一款参数量小、响应极快的模型,扛起 NLU 的重任。在不断的探索和尝试中,Jev 也走进了我们的视野。
目前模型架构、数据集构建方法、训练方式,全都闭源,也是把 closeAI 的精髓发扬光大了~
能力可以理解为通用版的 Bert,吹得比较凶,但或许通用性就是 Jev 最大的价值?Jev 之于Bert,类似 3D 打印之于开模。不再需要费劲打磨数据训练 Bert,也能获得一个能力接近的模型,应用到工程中。
官网及文档
TypeSafe AI 官网:Home - TypeSafe AI
两篇官方博客
介绍System One Models与Jev——TypeSafe AI博客
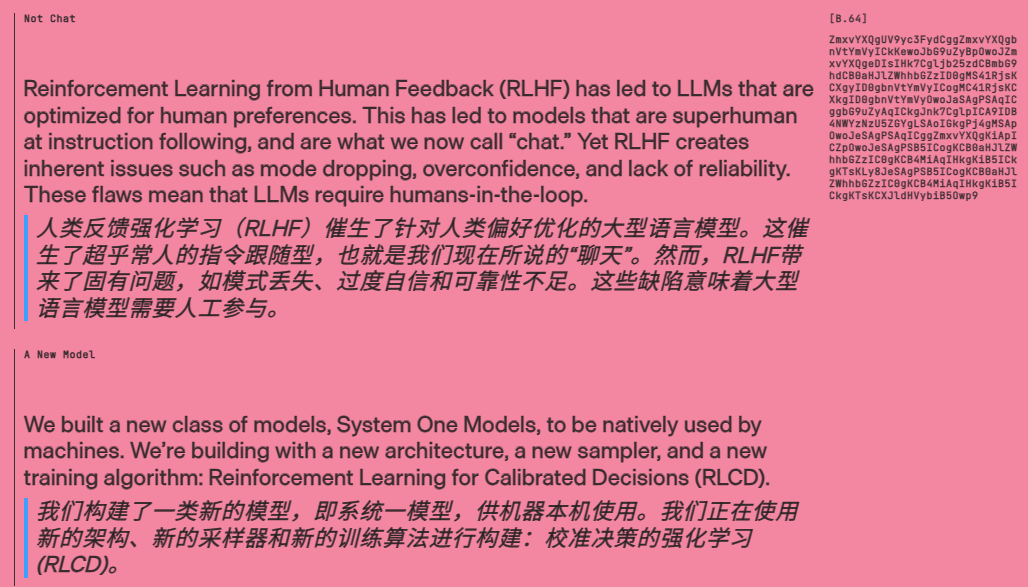
现有的 LLMs 优化方式是:RLHF (Reinforcement Learning with Human Feedback / 基于人类反馈的强化学习) 或者 RLVR (基于可验证奖励的强化学习)。它们优化的目标是让生成的文本更符合人类的偏好。
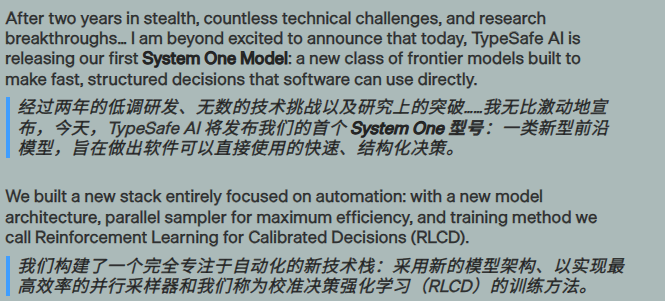
Jev 的优化方式则是:RLCD (Reinforcement Learning for Calibrated Decisions)。基于校准决策的强化学习。
RLCD 什么意思? “Calibrated decisions: answers with epistemically honest probabilities on System One tasks.”
意思是,RLCD 的训练目标不是生成好看的句子,而是为了在“系统一”任务中,输出经过校准的决策(Calibrated decisions)。这种决策会附带“认识论上诚实的概率”(epistemically honest probabilities)。
简单来说,这意味着模型在回答问题或做出分类时,不仅给出结果,还会给出一个极其精确且可靠的“自信程度”(比如“我有 95% 的把握是 A”)。而且这个概率是“诚实且经过校准的”——如果它说自己有 95% 的把握,那在统计学上它就真的只有 5% 的概率会出错,这彻底解决了传统大模型过度自信或胡说八道(幻觉)的问题,使其能够被代码安全地信任和调用。
The Bitterest Lesson - TypeSafe AI Blog
选择正确的任务 > 数据 > 算力 > 算法。
算力的威力只有在“任务”和“数据”都正确的前提下才能显现。机器学习中最重要的事情,往往根本不是机器学习本身,而是你到底让它去解决什么问题。
作者分享了他们在 OpenAI 研发 InstructGPT/RLHF 时的经验来证明这一观点: GPT-3 虽然在预测下一个 Token 方面表现出色,但人们真正需要的是一个能遵循指令的模型,而不是一个超级自动补全机。
他们发现,只要针对“正确的任务”进行训练,哪怕模型小 100 多倍(比如 GPT-2 级别的模型),使用最简单的算法和极少的算力,其表现也能彻底击败庞大的 GPT-3。 如果单靠扩大预训练的算力来达到这种指令遵循的效果,可能需要扩展到 GPT-7 甚至 GPT-9 的规模。
1. Jev 是什么
1.1 定位
Jev 是 TypeSafe 发布的 System One 决策模型:输入 state(待判断的内容)与 questions(本次要回答的问题),一次调用返回决策概率,不生成任何文本。官方发布的口径是”用概率做决策,而不是生成文字”。
- 任务由每次请求定义:问题的 instructions、候选的描述都随请求传入,不是只支持训练时见过的固定类别;
- 一次请求可携带任意多道问题,问题共享同一个 state,但相互独立——一道题不能读取另一道题的结果;
- 官方也用 Noul 返回 yes 概率这一形式与布尔决策对接。
1.2 已核验的接口事实
| 条目 | 核验结果 |
|---|---|
| 输入 state | 文本、JSON 对象、文本数组;当前不支持图像/音频/视频 |
| Choice | 1–255 个候选;返回完整概率分布与 confidence;选项名与描述进入模型,question id 不进入 |
| Score | 2–10 个有描述的有序等级;返回完整分布与 score = Σ i·p_i;等级数字与相邻等级不给模型,每级独立判断 |
| Noul | 返回命题为真的概率;可附加 true/false 说明 |
| 问题隔离 | 共享 state 的多问题并行、独立计算 |
| confidence | 由分布确定性计算出的集中度统计量,不是独立的”正确率预测”(公式见官方 MIT adapter:Choice 为 (max(p)−1/K)/(1−1/K),Score 基于与均匀分布的加权距离) |
| 版本与价格 | jev-1.13.0;输入 $0.042/百万 token,输出免费 |
| 上下文 | state+全部问题 64k token;state+最长单问题 32k token |
1.3 公开与未公开的边界
| 问题 | 状态 |
|---|---|
| 网络结构 | 未公开。创始人明确表示架构保密、团队讨论过写论文,并认为数据比架构更值得关注;仅认可社区”用动态候选替换固定词表、直接输出分布”的高层概括 |
| 参数量 / 基座 | 未披露(官方仅称并非”小模型或 LLM”) |
| RLCD | 只公布了名称与目标(面向校准决策的后训练);reward、loss、采样算法、优化器、数据量与算力均未公开 |
| 训练数据 | 官方自称自研数据,未给出清单与配方 |
| 训练/推理代码 | 未发现权重或训练源码;仅有公开 SDK、adapter 与 agent skills |
1.4 性能宣称怎么读
- 193.6× 更快、444.6× 更便宜:来自厂商自家工作流对比,发布文自认是收益区间的较高一端,且短输入演示对 Jev 有利;
- “零幻觉”:来自输出 schema 的构造性保证(输出只能是合法候选),不是对所有语义错误的统计——创始人本人也承认模型可能自信地答错;
- 官方评测:四个场景、参考标签由两个前沿模型的高推理设置答案取平均产生,测的是”与参考共识及工作流决策的一致性”,不是人工真值证明。
1.5 官方已知局限
过度按字面理解、计数与精确数值弱、日期比较不可靠、复杂间接指代弱、无关长上下文降低准确率、state 内恶意指令会影响答案、指令与 criteria 冲突、不能高效做文本生成。
2. RLCD 是什么
2.1 官方定位
RLCD 全称 Reinforcement Learning for Calibrated Decisions(面向校准决策的强化学习)。官方 AI primer 把它画成预训练语言模型之后的第三条后训练分支,与 RLHF、RLVR 并列。创始人在公开演讲中的补充:
- “I actually don’t think that pre-training is the problem.”——难点不是预训练,而是把已有能力引出来;
- “It is definitely not RLVR.”——明确与”可验证答案奖励”路线区分;
- 目标是 calibrated decision-making:把预训练能力转成软件可用的决策概率。
公开证据到此为止:RLCD 是一个路线名称与目标声明,不是可下载的算法配方。不能把任何现成优化器、Brier 损失或社区猜测直接称作 RLCD。
2.2 校准的对象:先区分三种概率
对输入 x = (state, question, criteria),至少存在三种不同的量:
- 事件概率:
P(退款已完成 | 可见信息)——Boolean/Noul 的语义; - 答案正确的概率:先给出答案
a,再报告P(a 正确); - 动作策略概率:
π(a|x)——代理选择动作的频率;最优行动可以是确定的,即使事件本身不确定。
三者混在一起讨论会让”更会赢”伪装成”概率更准”。严格校准要求 P(Y=1 | p=r) = r,且必须同时看分辨率——Brier 的总体分解:
1 | |
恒报全体基率的模型完全校准却没有分辨率;只压低校准误差会接受这种模型。目标因此是跨任务学习有语义的条件概率,而不是把输出压到一个好看的 ECE 数字。
2.3 为什么”采一个答案、答对就奖励”学不到概率
设模型从报告分布 p 采样答案 A,环境给出结果 Y,奖励只看答案对不对:
1 | |
这是 p 的线性函数,最优解在概率单纯形顶点(把概率全压到胜出类别)。二元”答对得 1 分”进一步展开:
1 | |
只要 q>0.5 最优就是 p=1,q<0.5 就是 p=0;多采几个答案取平均仍是同一线性目标。给正确性奖励再附加固定熵奖励也不修复:J + τH(p) 的最优是 sigmoid((2q−1)/τ),一般不等于 q。“鼓励多样性”与”校准”不是同义词。
2.4 Proper scoring:直接 CE/Brier 已经具备校准目标
若网络可微地输出概率向量,交叉熵与 Brier 的总体期望:
1 | |
两者的唯一总体最优都是 p = q。也就是说:直接对这些 loss 反传,就是校准目标本身,不需要把分布先采样成离散答案再用 REINFORCE。反过来,”只用 CE 训练就一定校准”也不成立——有限样本、模型失配、过拟合、标签偏差都会破坏理想条件;监督 CE/Brier 是必要对照,而不是可以跳过对照的理由。
2.5 采样形式的 proper 目标
如果希望采用”采样器参与训练”的 RL 形式,可以构造一条与 proper score 严格对应的样本级奖励。独立采样 A, B ~ p,给观测结果 Y:
1 | |
期望的唯一最优同样是 p = q;第三项(样本间一致性惩罚)防止把分布压到单一答案,是 Brier 目标的样本估计。M≥2 样本版把第二项改为排除自配对的两两惩罚;有序 Score 对应负 CRPS。成立条件:两个采样必须条件独立、来自同一分布;梯度包含两条采样路径。需要强调:这是对目标形式的一般推导,不是 Jev 已知的训练法——“尚未被排除”不等于”官方确认”。
3. Jev 与自回归大语言模型的区别
3.1 输出形态与推理机制
| 维度 | 自回归 LLM | Jev |
|---|---|---|
| 输出 | token 序列(文本),答案存在于生成内容里 | 概率分布向量(候选上的 normalized 概率),不存在生成文本 |
| 推理 | token-by-token,每步依赖前一步;答案之间串行等待 | 官方口径”不是逐 token 生成”;多问题/多候选可并行计算 |
| 解析 | 生成 JSON/数字/标签后由代码 parse,有格式错误与解析失败面 | 直接输出结构化概率,无解析步骤;不可能输出不存在的选项 |
| 思维链 | 可显式 CoT,推理写在输出里 | 创始人明确:不允许 latent reasoning(即 chain-of-thought);System 2(顺序推理)放在代码组合层,模型本体是可靠的 System 1 |
创始人把 Jev 相对 LLM 的变化类比为 Transformer 相对 RNN 的变化:把顺序计算换成并行计算;并称 “Jev can’t generate text” 是能力边界也是设计选择。
3.2 概率语义
- LLM 的 token 概率是”该提示下的续写分布”,不等于语义置信;RLHF 后常更过度自信,文本里自报的
confidence: 0.97只是自报数字; - Jev 把校准概率当作训练目标(RLCD):80% 概率对应的事件应约 80% 发生,且概率直接供程序阈值决策使用;
- 对公开 API 的直接探测还能观察到一个只有拿到分布才能观察的现象:同一 50% 随机事件,Jev 的 Choice 给出 0.89–0.95,而 Noul 给出 0.48–0.49(70% 事件为 0.99–1 vs 0.69)——Choice 偏尖锐、Noul 接近标注值。这说明同一系统的不同原语给出的概率语义可能并不一致,跨原语一致性本身值得单独测试。
3.3 并行结构:四个必须分开的轴
把”并行”拆成四个独立概念,可以避免宣传话术混淆:
- 不同 state 的 batch 并行:决定硬件吞吐;
- 同一 state 多题/多候选并行:一次张量计算得到全部候选分数,资源开销与候选数近似无关(参数规模不依赖 K);
- 同一 state 共享前缀计算:避免每个候选重复编码长 state(官方 demo:13 问题批处理 0.27s / $0.000497,逐题串行 2.71s / $0.006090);
- 输出非自回归:当前决策不依赖刚生成的决策,没有 token 解码循环。
满足第 1、2、4 项不自动满足第 3 项。”因果 Transformer”也不意味着必须调用自回归生成——对已给定的输入序列,一次 forward 即可读取全部所需表示,无需逐 token 解码。
3.4 两者的关系
- 共同点:都可以用因果 LM 做底座。Jev 内部结构未公开,不能断言它就是”decoder + 概率头”;但公开证据(创始人认可”动态候选替换词表”的高层描述、no-CoT 披露、非生成接口)与”因果骨干 + 直接概率读出”的路线完全兼容;
- 边界声明:”不生成文本”是官方原话;”单次前向”是实现层面的工程选择,不是对 Jev 内部前向次数的断言;迭代式非自回归采样器在数学上未排除。
4. Jev 与 BERT 的区别
4.1 相似点
两者在推理形态上确实同类:都是判别式模型——读一次输入的隐藏表示,加一个轻量头输出结果,不做生成。BERT 微调后一次 forward 输出分类 logits;Jev/决策头结构一次 forward 输出候选分布。两者的分类头都很小(BERT 是 pooler+linear,决策头通常只是轻量的读出网络)。
4.2 区别一:任务定义与分类头
| 维度 | BERT 微调范式 | Jev |
|---|---|---|
| 标签集 | 训练时固定;每个任务一套分类头权重,类别数与数据绑定 | 每次请求用自然语言定义问题与候选;同一模型零样本处理未见任务 |
| 类别数 | 分类头维度固定,改类别数要换头 | 动态候选(1–255),参数规模不依赖 K |
| 标签语义 | 类别 ID | 候选的语义描述进入模型;纯机器索引不作为标签语义 |
给每个已见任务固定一个分类头的方式,只能复现固定标签分类器,无法覆盖”规则、候选、问题随请求变化”的可编程决策契约。
4.3 区别二:输出语义
- BERT 的 softmax 分数是训练目标下的分类分数,不承诺校准(深度网络的过度自信是独立研究课题,温度缩放是常见后处理);
- Jev 的输出是给程序决策用的校准概率,这是 RLCD 存在的理由之一。分类正确率高不等于概率可信——评价要分开:K 分类正确率、NLL/Brier、可靠性图、risk–coverage 曲线是四组不同证据。
4.4 区别三:架构与预训练目标
| 维度 | BERT | Jev |
|---|---|---|
| 注意力 | 双向 encoder(token 可看到全文) | 内部未公开 |
| 预训练 | MLM 填空 | 未公开 |
| 生成能力 | 无 | 无(官方明确 “can’t generate text”) |
Jev 的注意力与预训练目标从未公开。公开证据(非生成接口、动态候选、无 CoT)与”因果骨干 + 直接概率读出”的路线兼容;若采用这类路线,因果骨干相对双向 encoder 的工程取舍是:
- 共享前缀的兼容性:因果骨干天然支持”不读取未来分支的前缀缓存”,长 state 只编码一次、各问题/候选分支复用 KV;双向 encoder 全体 token 互相可见,要做同等的 state 共享需要 state-only 注意力或专门的 cross-attention,改结构会改变函数,无法与原因果前向保持严格数值对照;
- 预训练表征与指令理解:动态候选+任意 instructions 的零样本能力依赖现代预训练;encoder 类权重是 MLM 起点,需要补足 instruction-conditioned 训练;
- 树注意力实现:共享 state 前缀树需要专门的注意力掩码定义(state 只看 state、问题看 state+自己、候选看 state+本题+自己);用普通下三角掩码处理整棵树会泄漏兄弟分支。
4.5 encoder 类模型与决策头
encoder 类模型是承载决策头的另一条可行路线,代表是 GLiClass(ModernBERT,约 151M,原生动态标签分类,一次前向对临时标签评分)、mmBERT-small(多语言)、ModernBERT 等。两点差异值得注意:
- GLiClass 的”一题全部候选联合编码”方式效率更高,但候选互相可见,与 Score”每级独立判断、不看相邻等级”的官方语义不符;逐候选独立打分 + 题内归一化的结构更通用;
- 逐候选独立打分有结构限制(IIA):
p_i/p_j = exp(z_i−z_j),加一个候选不改变原两项的相对赔率——对”选最接近平均值”这类集合依赖规则不成立。一种修补是在候选集合上加一层置换等变的小型集合注意力(对 Choice 适用;Score 可保持等级隔离)。
4.6 总结
BERT 是”固定标签集的判别式分类器”;Jev 是”请求时定义任务、输出校准概率的判别式决策器”。 两者共享”非生成、读隐藏态”的推理形态,但任务契约、输出语义与骨干选择都有明显差异。encoder 可以承载决策头(GLiClass 是近邻证明),但在前缀共享、表征强度等工程维度上各有取舍。
5. RLCD 与 RLHF 的区别
5.1 官方图谱
官方 AI primer 把 RLCD 与 RLHF、RLVR 并列为预训练 LM 之后的第三条后训练分支。三者的目标不同:
| RLHF | RLVR | RLCD | |
|---|---|---|---|
| 全称 | Reinforcement Learning from Human Feedback | RL with Verifiable Rewards | RL for Calibrated Decisions |
| 优化什么 | 人类偏好(更有用、更无害、更讨喜欢) | 可验证答案的正确性 | 决策概率的校准质量(概率与结果频率相符) |
| 反馈信号 | 人类比较(chosen/rejected 对) | 程序判定的对错 | 真实结果/概率质量反馈(官方未公开细节) |
| 奖励作用于 | 生成的回答序列 | 生成的推理与答案 | 报告的概率分布本身 |
5.2 数学差异:为什么偏好/正确性奖励不够
这是 RLCD 区别于 RLHF/RLVR 的核心论证(推导见 2.3 节):
- RLHF 的偏好奖励:奖励”像人类偏好的回答”。创始人在演讲中把它类比 GAN 的 mode dropping——偏好奖励使模型学会”自信地表达”,这与校准概率的目标不同甚至相反;
- RLVR 的正确性奖励:奖励”答对”。对概率输出而言,正确性奖励是
p的线性函数(见 2.3 节),最优解在单纯形顶点——学到的是”押注胜出类别”,不是诚实的条件概率。创始人对此的表述是 “It is definitely not RLVR”; - RLCD 的目标:必须让奖励/损失评价整个分布(proper scoring)。Brier、log score、配对样本奖励等以
p=q为唯一总体最优的目标才能恢复频率含义。若全部类别 logits 可微且真值可得,直接反传 proper loss 已经完成同一件事——RL 形式的必要性必须在受控对照中证明。
5.3 数据与反馈的差异
| 维度 | RLHF | RLCD(已知边界内) |
|---|---|---|
| 反馈主体 | 人类标注偏好 | 真实结果 / 校准反馈(官方仅公布方向) |
| 反馈性质 | 主观、序数(A 比 B 好) | 与事件频率可对照(80% 概率约 80% 发生) |
| 标签来源要求 | 偏好数据集 | 需要”决策当时的输入与后来结果”或”已知生成机制的随机事件样本”;teacher 自信度不能当频率真值 |
| 失败模式 | 讨好、过度自信、偏离事实 | 只学 argmax(正确性奖励)、教师分布模仿≠真实校准 |
5.4 实践中的判别要点
- 直接 CE/Brier 是一等对照:先证明目标本身的正确性,再讨论优化器;声明 RL 贡献必须展示同数据、同骨干、同算力下的指标改善;
- 采样形式不是默认更优:候选集不大、全部类别 logits 可微且真值可得时,直接反传 proper loss 更简单;只有采样/交互/不可微反馈才让 RL 形式有额外动机;
- 模仿与校准分开验收:与教师分布的 KL 下降只证明”更像教师”;独立真值上的 NLL/Brier 才回答”概率是否可信”——教师概率不能不加区分地当软标签使用;
- RL 的合理触发条件:动作影响环境、反馈延迟且不完全、概率不可微、或采样器本身参与训练时;”有一堆标签没标”不是使用 RL 的充分理由。
6. 总览速查表
| 问题 | 结论 |
|---|---|
| Jev 是自回归 LLM 吗? | 不是。不生成文本、不做 token 解码、无 CoT;顺序推理交给代码组合 |
| Jev 是 BERT 式的分类器吗? | 推理形态同类(判别式、非生成),但任务与输出不同:请求时定义动态候选、输出校准概率 |
| Jev 与 LLM 的底座关系? | Jev 内部架构未公开;”因果 LM 骨干 + 概率读出”与公开证据兼容,是一条可行的实现路线 |
| RLCD 是 RLHF 的一种吗? | 不是。官方将其与 RLHF、RLVR 并列;优化目标是校准决策概率,而非人类偏好或答案正确性 |
| RLCD 与 RLVR 的区别? | 正确性奖励对概率是线性目标(最优在顶点),学不到校准;RLCD 需要分布级 proper 目标 |
| RLCD 用什么算法? | 未公开。一种候选方向是”多样本 proper reward + 采样器”;直接 CE/Brier 为严格对照 |
| 为什么不能直接相信”概率”? | 分类分数≠校准概率;需要独立真值、proper score、分辨率与 risk–coverage 证据 |
7. 事实核验边界
- 官方已披露:接口语义(三原语、问题隔离、动态候选)、no latent reasoning/CoT、”not RLVR”、RLCD 名称与目标、性能宣称口径、已知局限;
- 推导与分析:proper scoring 与采样化奖励的数学形式、因果骨干与共享前缀/树掩码的工程取舍、对 Jev 公开 API 观察到的原语概率语义差异(观察记录,非官方披露);
- 未知:Jev 网络结构、参数量、基座、RLCD reward/优化器/采样器、训练数据配方。对未知部分的任何具体化表述都只是假说。
8. 公开来源
| 内容 | 来源 |
|---|---|
| Jev 产品与定位 | TypeSafe 官网:https://typesafe.ai/ |
| State 与三原语契约 | 官方文档:https://docs.typesafe.ai/(concepts/state、primitives/choice、primitives/score、primitives/noul) |
| 无 CoT / no latent reasoning 表态 | 创始人帖子:https://x.com/CompleteSkeptic/status/2099981459541143995 |
| RLCD 与 RLHF、RLVR 并列的官方定位 | TypeSafe 官方 AI primer 及创始人公开演讲(正文转述) |
| 校准与 proper scoring 数学 | 概率校准的标准结论(Brier 分解、proper scoring 唯一最优性) |