20 TOPS 凭什么逆袭 100 TOPS?揭秘 Decode 阶段内存挑战与芯片级应对路线
20 TOPS 凭什么逆袭 100 TOPS?揭秘 Decode 阶段内存挑战与芯片级应对路线
评估端侧 AI 芯片的性能时,算力(TOPS)是主要的参考指标。在传统的 CNN 等深度学习任务中,较高的算力往往对应着更好的表现,但在大语言模型的端侧推理部署中,情况却发生了变化,你会发现某些 20 TOPS 芯片,推理速度能超过 100 TOPS 芯片:
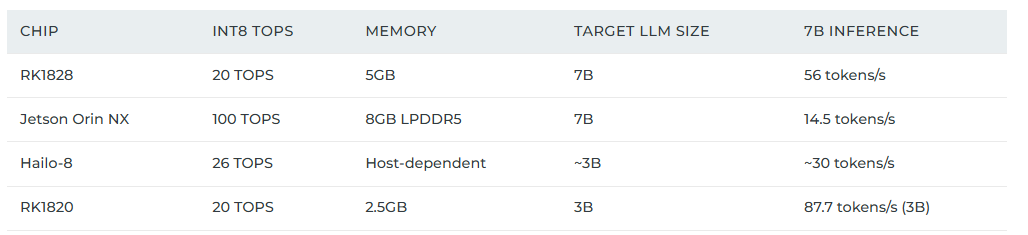
如图,推理 7B 模型时,标称算力 100 TOPS 的 Jetson Orin NX,推理速度约 14.5 tokens/s;而标称算力 20 TOPS 的瑞芯微 RK1828,推理速度却能达到 56 tokens/s。
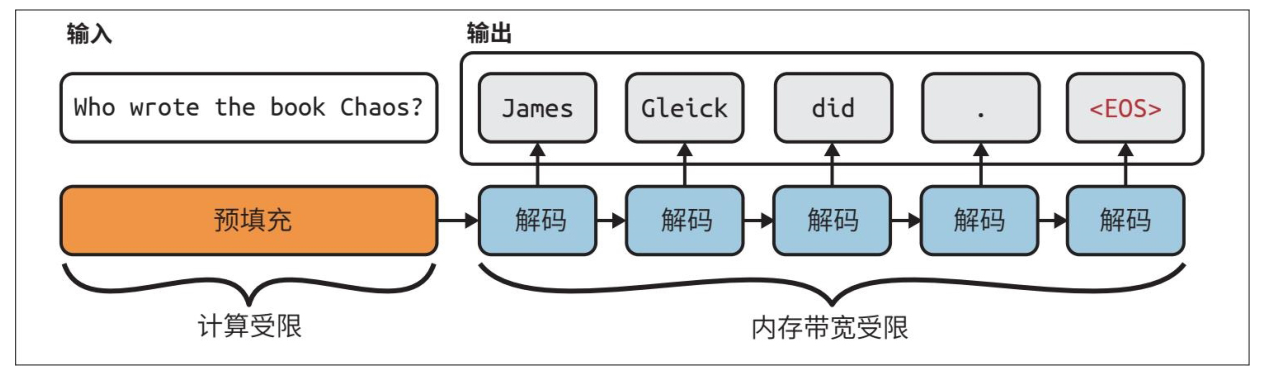
导致这种性能倒挂的核心原因,在于大模型生成文本的工作机制。在 LLM 的 Decode 阶段,系统每生成一个新的 Token,都需要读取完整的模型权重。此时限制系统整体吞吐量的通常不再是算力,而是数据传输的通道带宽。
本文将从 LLM Decode 阶段的硬件执行逻辑切入,分析 GPU 和 NPU 在数据搬运过程中的带宽受限原理,并梳理 NVIDIA、高通、瑞芯微等厂商在应对这一挑战时,所采用的不同系统架构与芯片级内存设计路线。
1 Decode 阶段搬运 KVCache,是从哪里搬到哪里?
从 GPU 的高带宽显存(HBM,High-Bandwidth Memory)搬运到 GPU 内部的片上缓存(On-chip SRAM)。
对于搬运数据导致的带宽瓶颈,技术文章 共同设计 AI 模型注意力,实现快速的交互式长上下文推理 - NVIDIA 技术博客 中对这点也作出了解释:
As agentic and long-context workloads become common, the context lengths increase and attention consumes a larger share of inference time (Figure 1). Because attention now dominates that cost, how it is designed—not just how it is implemented—increasingly determines a model’s inference performance. Shaping model architecture around how GPUs execute it is the premise of AI model co-design. For a discussion of how model design choices impact both throughput and interactivity without sacrificing accuracy, see the previous post, AI Model Co-Design: Hardware-Friendly LLM Design.
- 单步生成导致低计算量:在没有使用投机解码(Speculative decoding)的情况下,Decode 阶段一次只能生成一个 Token。这导致矩阵乘法(GEMM)的规模非常小,算术强度(Arithmetic Intensity,即计算量与数据读取量的比值)很低。
- 反复的数据搬运:为了计算注意力(Attention),GPU 必须把过去所有 Token 生成的 Q、K、V 矩阵块(Tiles),从容量大但速度相对较慢的 HBM,像流水线一样读取(Stream)到容量小但速度极快的 SRAM 中进行计算。
- 带宽成为瓶颈:由于计算量远小于数据的搬运量,GPU 的计算单元大部分时间都在“等待”数据从 HBM 传过来,因此整个 Decode 阶段的速度就被 HBM 的读取速度(即内存带宽)死死卡住,成为了内存受限(Memory-bound)。
这篇文章 LLM 基准测试:基本概念 - NVIDIA 技术博客 里面也有侧面提及:
KV Cache 的持续膨胀:文章指出,随着输出序列变长,KV Cache 会不断增长,因此内存开销也随之增大。
非计算受限:计算每个新 Token 的注意力成本随着已生成的序列长度呈线性增长,但这部分计算“通常不受计算能力限制(Not compute-bound)”。
依赖带宽:文章明确提到,在 Decode 阶段,稳定的字元间延迟(ITL)标志着系统具备高效的内存管理和更好的内存带宽。
2 高带宽显存(HBM)与片上缓存(SRAM)
NVIDIA RTX 4090
4090 木有 HBM。。。HBM 成本极高,通常只用于 A100、H100 等数据中心级 GPU。
RTX 4090 的显存是 GDDR6X。
但无论是 GDDR6X 还是 HBM,它们都属于片外显存(Off-chip DRAM),而片上缓存(On-chip SRAM)则是直接蚀刻在芯片内部的。
以 RTX 4090(Ada Lovelace 架构)为例,其核心结构由外到内分为:
- 片外显存(DRAM):24GB GDDR6X,负责存储海量的模型权重和完整的 KV Cache。
- 片上 L2 缓存(SRAM):72MB。这是整个 GPU 共享的高速缓存,用来缓冲从 GDDR6X 搬进来的数据。
- 流式多处理器(SM):GPU 的核心计算块,包含 CUDA 核心和计算矩阵的 Tensor 核心。每个 SM 内部配备了极快的 L1 缓存/共享内存(SRAM,约 128KB) 和 寄存器文件(Register File,SRAM)。
在 Decode 阶段,数据是从片外的 GDDR6X(或 A100 的 HBM),经过 L2 缓存,再搬运到 SM 内部的 L1 缓存和寄存器,最后交给 Tensor 核心进行计算。
A100
A100 是有 HBM 的,可以用 torch 打印直观看看片外显存(total_memory)与片上 L2 缓存(L2_cache_size)

1 | |
输出:
1 | |
也可以用 deviceQuery 工具看。只要装过 cuda 就能用:
1 | |
输出:
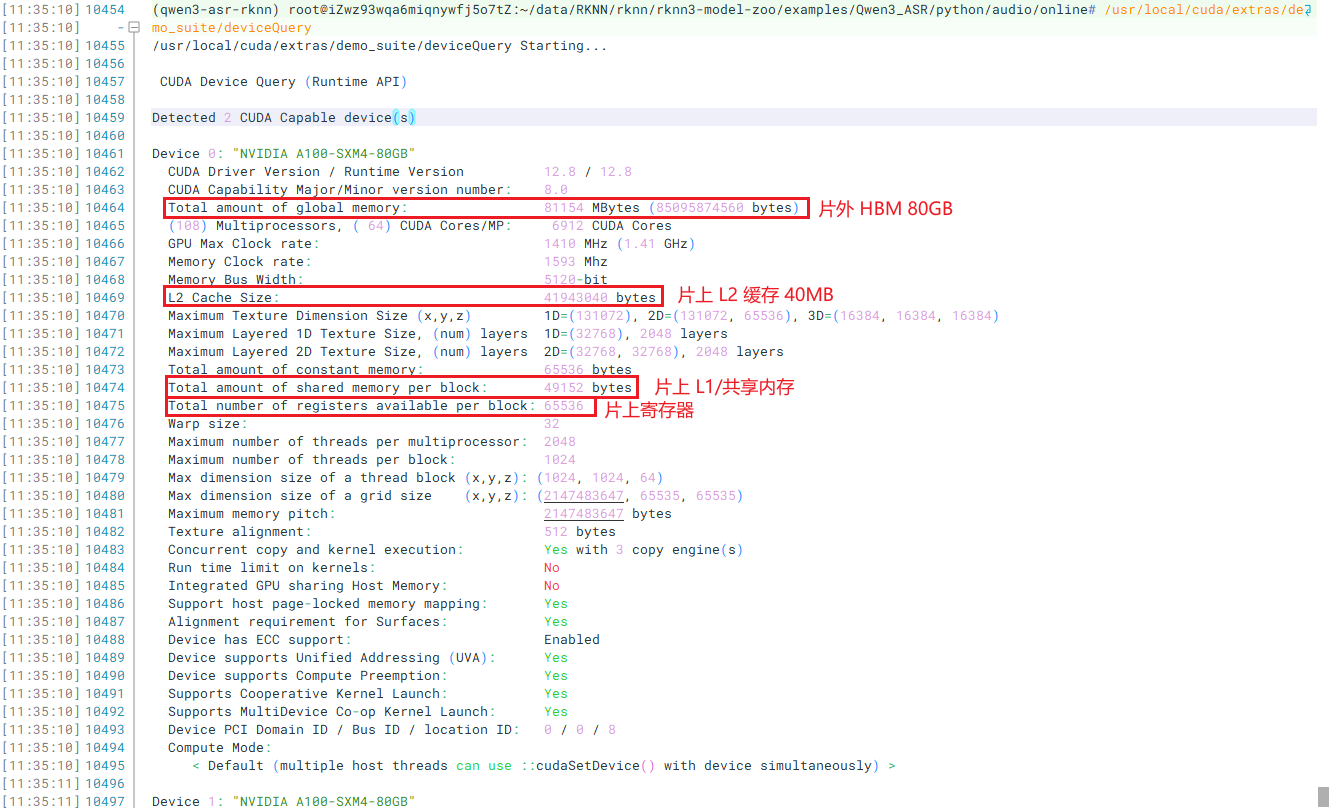
片外 HBM:
Total amount of global memory: 81050 MBytes片上 L2 缓存:
L2 Cache Size: 41943040 bytes(即 40MB)片上 L1/共享内存:
Total amount of shared memory per block: 49152 bytes(SM 级别的 SRAM)(108) Multiprocessors, ( 64) CUDA Cores/MP: 6912 CUDA Cores
- 108 个流多处理器(SM),每个 SM 有 64 个 CUDA 核心,共计 6912 个。
- 用于执行矩阵运算,但 A100 并不是靠 CUDA 核心数量取胜的,它真正强的是隐藏在这里没列出来的张量核心(Tensor Cores),专门加速 AI 矩阵相乘。
片上寄存器:
Total number of registers available per block: 65536每个块可用的寄存器数量。寄存器比 L1 缓存还要快,是直接嵌在计算单元里的极速存储。
Peer access from … (GPU0) -> … (GPU1) : Yes (位于输出的最底部):两张 GPU 之间可以互相“串门”访问对方的显存。
这是这台服务器最值钱的特性之一。 这意味着两张 A100 之间开启了 NVLink 高速互联。当运行大模型需要跨卡并行时,GPU 0 可以直接读取 GPU 1 的显存,而不需要绕道慢速的 CPU 内存。
瑞芯微 RK1828 (NPU)
RK1828 是专为端侧大模型推理设计的协处理器,它的架构为了解决带宽瓶颈做了特殊设计:
- 计算单元:专用的张量乘加器(MAC Arrays),用于 INT8/FP16 等计算。
- 片外存储(类 HBM 方案):RK1828 没有采用传统的外部 LPDDR 方案,而是采用了 3D 堆叠 DRAM 架构(内置 5GB DRAM)。这种封装级的高带宽内存(几百 GB/s)在逻辑和物理形态上非常接近 HBM 的概念,能大幅降低数据传输过程中的延迟。
- 片上缓存(SRAM):NPU 内部通常配有紧耦合内存(TCM)或片上全局 SRAM(Global Buffer),用于缓存网络层的激活值。
高通 SA8797 (Hexagon CDSP)
SA8797 是一款面向智能座舱/智驾的旗舰芯片,其内部的 CDSP(计算 DSP)主要用来处理 AI 任务:
- 计算单元:包含 HTA(张量加速器)和 HVX(向量扩展单元)。
- 片外存储(无 HBM):车规级和移动端芯片考虑到成本和功耗,通常不支持 HBM,而是与 CPU/GPU 共享 LPDDR5X 内存(例如 256-bit 位宽)。
- 片上缓存(SRAM):CDSP 内部拥有专属的 VTCM(向量紧耦合内存,Vector Tightly Coupled Memory)。这块巨大的 SRAM 完全由系统或编译器显式管理,功能上相当于 GPU 的共享内存,此外还有芯片级的 SLC(系统级缓存)辅助。
3 GPU 上的 FlashAttetion 计算
图片来源:共同设计 AI 模型注意力,实现快速的交互式长上下文推理 - NVIDIA 技术博客
FlashAttention 在不实现完整注意力矩阵的情况下计算注意力。它将 𝑄、𝐾 和 𝑉 的图块从 HBM 流式传输到片上 SRAM,并将三个步骤融合为一个通道:
- 首先,batched matmul (BMM1) 对关键帧的查询进行评分
- 其次,在线 Softmax 使用运行中的最大值和总和对分数进行归一化
- 第三,第二批 matmul (BMM2) 对值进行加权
BMM 在 Tensor Core 上运行,而 softmax 指数在特殊功能单元上运行。BMM 形状驱动随后的算术强度分析。
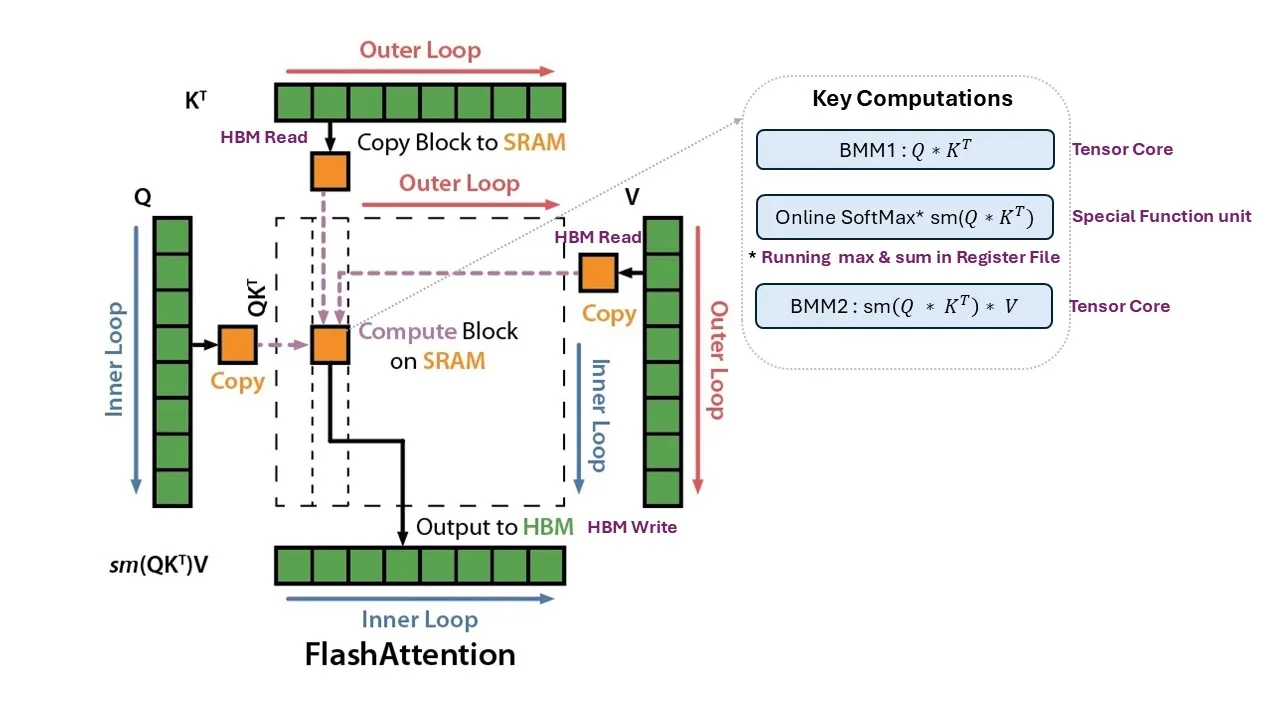
图 3. FlashAttention 内核在 Tensor Core 上采用 BMM1 和 BMM2,并在特殊功能单元上融合了在线 Softmax。图像改编自 FlashAttention:通过 IO 感知实现快速且高效的精确注意力
从这张图可以看到两个信息:
GPU 上的注意力计算,会将数据在显存(例如 HBM,GDDR)和高速缓存(SRAM)之间来回倒腾,再进入寄存器交由 Tensor Core 计算。
类似于 CPU 计算,数据会顺着 DDR -> L3 Cache -> L2 Cache -> L1 Cache -> 寄存器的路径一路搬运。
注意力矩阵 𝑄、𝐾、𝑉 并非整个计算,而是切成小块,内外层循环分别遍历,每次拿 𝑄、𝐾、𝑉 的一小块到 SRAM 中进行三步计算:
当前$Q$ 块与当前 $K^T$ 块的点积(BMM1)-> 更新 Softmax 分数 -> 再乘以当前 $V$ 块
Online Softmax
题外话,这里所谓“更新 Softmax 分数”是什么意思?何为“更新”?
要理解这个设计方式,就要先理解原版的 Softmax 是怎么计算的。
在标准的《Attention is All You Need》传统注意力机制中,需要等当前层的一整行 $Q$ 和所有的 $K$ 乘完,拿到完整的 $QK^T$ 分数矩阵后,才能计算 Softmax, Softmax 计算分两步,且这两步都依赖全局视野:
- 找最大值 (Max):为了防止计算指数时数值溢出(爆显存/无穷大),必须先找出整行原始分数中的最大值,然后让整行每个数都减去这个最大值(即 $e^{x - \text{max}}$)。
- 算总和 (Sum):计算分母时,需要把整行所有减去最大值后的指数结果全部加起来。
而在实际计算过程中,SRAM 容量小,装不下完整的 K 矩阵,只能计算局部的 $Q_{\text{block}}$ 与 $K^T_{\text{block}}$,此时既不知道整行的全局最大值是多少,也不知道全局总和是多少,按传统方法,无法进行 Softmax 和后续乘 $V$ 的操作。
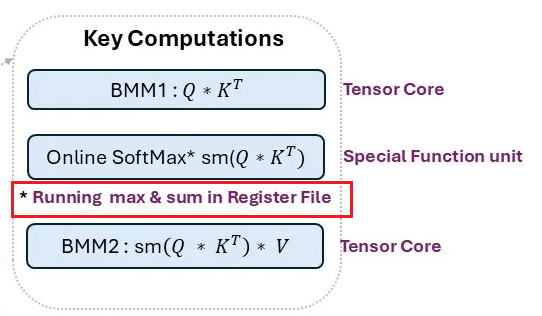
为了解决这个矛盾,就有了 Online Softmax。 图片标注的 * Running max & sum in Register File(在寄存器文件中维护运行时的最大值和总和)就是 Online Softmax 算法。它利用数学恒等式,把必须一次性算完的 Softmax 拆解成了可以边算边调整的“增量更新”过程:
假设一行 $QK^T$ 数据被分成了两块(Block 1 和 Block 2)先后进入 SRAM 计算:
- 处理 Block 1 时:算出局部片段的最大值 $m_1$ 和总和 $l_1$,并用它们先算出一个临时的 Softmax 结果,进而与对应的 $V_1$ 乘出一个临时输出。此时,GPU 寄存器存下 $m_1$ 和 $l_1$ 。
- 处理 Block 2 时:算出这部分片段的局部最大值 $m_2$。此时,算法将新旧最大值对比,得出一个新的“当前全局最大值” $m_{\text{new}} = \max(m_1, m_2)$。
- 构造一个缩放因子 $e^{m_{\text{old}} - m_{\text{new}}}$。如果最大值变了,则用这个因子去乘以之前暂存在寄存器里的旧总和与旧输出,进行等比例缩放补偿,再把 Block 2 的新结果累加进去。
这种边算点积、边计算局部指数、边用缩放公式实时修正并累加之前状态的过程,就是图中所说的更新在线 Softmax 分数。
原理很简单,就是指数恒等变换:$$e^{x - m} = e^{x - m_A + m_A - m} = e^{x - m_A} \cdot e^{m_A - m}$$
其中,$e$ 是底数,$x$ 是 $QK^T$ 结果矩阵中的某一个具体的原始注意力分数。$m$ 是当前的全局最大值,随着新的数据块不断被处理,算法对比所有已见过的数据后,更新得出的最新的、更大的最大值。$m_A$ 是之前的局部最大值。也就是当硬件之前在 SRAM 里专门处理数据块 A 时,仅仅在块 A 内部找到的最大分数。
$e^{x - m}$ 是需要计算的目标结果。为了防止 Softmax 运算溢出,标准做法是用当前真正的全局最大值 $m$ 来对元素 $x$ 进行减法偏移后,再求指数。
$e^{x - m_A}$ 是过去已经算过的历史数据。在处理数据块 A 时,硬件还没看到后面的数据,只知道局部最大值 $m_A$,所以当时计算并存在寄存器里的局部总和,都是由这种基于 $m_A$ 的指数项累加构成的。
$e^{m_A - m}$ 是缩放因子,代表了“旧的局部最大值”与“新的全局最大值”之间差值的指数。
4 RK1828 的 1024GB/s 带宽,和 SA8797、Orin NX 的带宽是一个东西吗?
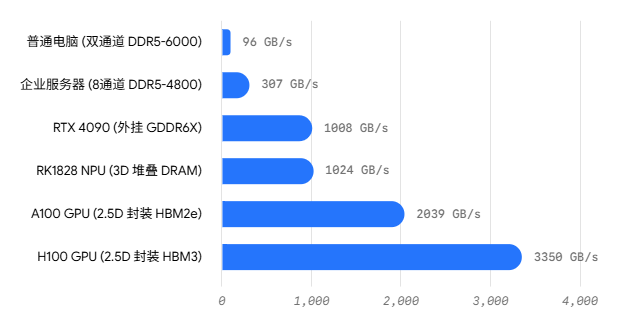
不是的朋友,不是的。
当我们说 RK1828 拥有 1024 GB/s 的超大带宽时,指的是 NPU 计算核心与它内部封装的 5GB 3D 堆叠内存(3D-Stacked DRAM)之间的传输带宽。
而英伟达和高通的带宽(几十到一百多 GB/s),是系统总内存与整个 SoC 芯片之间的共享带宽。
这里涉及到一个非常核心的芯片架构概念:统一内存架构(UMA, Unified Memory Architecture)。
统一内存架构 UMA
像高通 SA8797 和英伟达 Orin NX 这样的芯片是 SoC,也就是说芯片上不仅有 NPU(英伟达叫 DLA,高通叫 Hexagon DSP),还有 CPU、GPU、ISP(处理摄像头图像的模块)、显示控制器等等。
这些计算单元都没有自己专属的显存,而是共同合租主板上的几颗 LPDDR5 内存颗粒。因此,宣传里写的 100 GB/s,是整个芯片系统读取外部 LPDDR5 的极限总带宽。
当在这样的 SoC 平台上跑 Decode 阶段时,NPU 通过 LPDDR5 总线把权重和 KV Cache 搬运到芯片内部。此时会面临两个问题:
- 绝对上限低:哪怕 NPU 把通道全占满,也只有 100 GB/s 左右,跑小模型可以,跑大模型依然会带宽受限。
- 需要抢夺资源:在实际的智能座舱或机器人应用中,内存带宽并不是 NPU 独享的。车载屏幕的 UI 渲染(GPU)、多个摄像头的画面摄入(ISP)、底层操作系统(CPU)都在同时读写这块 LPDDR5。NPU 实际分到的大模型推理带宽,会比标称值更小。
内存形态对比:DDR5 LPDDR5(X) 片内3D堆叠
传统的端侧 AI 平台(例如 NVIDIA Jetson Orin NX)主要依赖外挂 LPDDR5 内存,受限于物理引脚数量和外部传输距离,其内存带宽通常只有 68 GB/s 左右。
英伟达 Jetson Orin NX:官方资料标称带宽 102.4 GB/s,用的 128-bit 的 LPDDR5 内存。
高通 SA8797:顶级车规级 SoC,搭配频率更高的 LPDDR5X 内存,总带宽通常在 100 GB/s 到 135 GB/s 左右。
而瑞芯微 RK1828 的定位是“专为大模型推理设计的 AI 协处理器”,没有走外挂内存的路线,而是在芯片封装内部,与 NPU 裸片 3D 堆叠了 5GB 的 DRAM。
1024 GB/s 的高带宽,是 NPU 计算核心与这块片内 5GB 专属堆叠内存之间的内部传输速度。由于同在一个封装内,得以打破外部电路板的走线限制,总线可以做得极宽。
| 内存形态 | 代表平台 | 带宽范围 | 资源归属 | 大模型表现 |
|---|---|---|---|---|
| 插槽式 DDR5 | 普通电脑 / x86 服务器 | ~96 GB/s | 系统全局共享 | 极差(物理距离远,带宽极低,纯 CPU 跑不动) |
| 板载外挂 LPDDR5(X) | Orin NX / 高通 SA8797 | 100 ~ 200 GB/s | 系统全局共享 (SoC 统一内存) | 一般(距离拉近,但依然受限于主板走线,且需与 CPU/GPU 抢带宽) |
| 片内 3D 堆叠 / HBM | RK1828 (DRAM) / A100 (HBM) | 1000 ~ 2000+ GB/s | AI 算力核心独享 | 极佳(彻底消灭物理引脚限制,内部超宽总线专门伺候 NPU/GPU) |
DDR5 与 LPDDR5 的区别
那么 LPDDR5 和 DDR5 的区别又是什么,LP 是什么意思,DDR 是什么的缩写,5 是指第五代吗?
图片来源:瑞芯微 SoC 平台 DDR 适配提速!
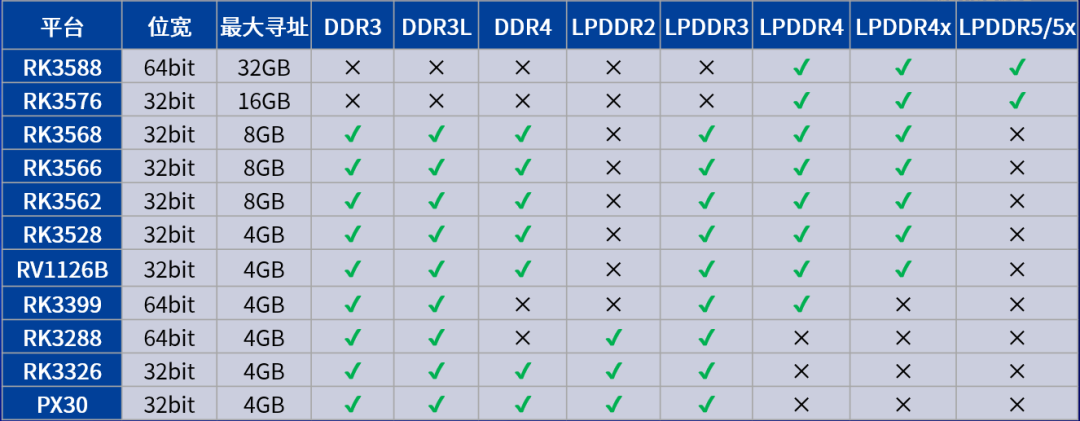
DDR 代表 Double Data Rate(双倍数据速率)。早期的内存只能在时钟信号的上升沿传输数据,而 DDR 可以在上升沿和下降沿各传输一次,相当于相同频率下数据传输量翻倍。
5 确实代表 第五代(5th Generation)。这是 JEDEC(固态技术协会)制定的内存行业标准,从早期的 DDR1 一路演进到了目前的 DDR5。
LP 代表 Low Power(低功耗)。LPDDR 就是在普通 DDR 内存的基础上,专门为移动设备和电池供电设备定制的低功耗版本。
它们虽然名字相似,但底层设计逻辑和物理形态有很大差异:
| 特性 | 普通 DDR5 | LPDDR5 (低功耗版) |
|---|---|---|
| 物理形态 | 插拔式内存条(DIMM)。体积大,距离 CPU 较远,用户可以自行升级和更换。 | 不可拆卸的芯片颗粒(BGA)。直接焊接在主板上,甚至与 SoC 封装在同一块基板上。距离计算核心极近。 |
| 核心设计目标 | 高容量、高扩展性。主要靠插多根内存条来提升总线位宽和总容量。 | 极致省电、高集成度。拥有极具侵略性的休眠机制和动态电压调节功能。 |
| 功耗表现 | 较高。主要用于插电运行的设备,对功耗不敏感。 | 极低。待机和运行功耗远小于普通 DDR5。 |
| 频率与延迟 | 基础频率通常起步于 4800 MT/s。因为走线长,延迟通常稍低一些。 | 理论频率极高(LPDDR5X 可达 8533 MT/s 以上)。为了弥补低功耗带来的性能损失,通过极短的物理连线拉高了频率。 |
| 典型应用场景 | 台式电脑、大型工作站、数据中心服务器。 | 智能手机、轻薄笔记本(如 MacBook)、车载计算平台(高通 SA8797)、边缘 AI 设备(Orin NX)。 |
像高通 SA8797(智能座舱)和英伟达 Orin NX(边缘计算)这种芯片,面临的环境往往是汽车电瓶供电或者小型机器人,对功耗和发热有着严苛的限制。并且,端侧芯片内部的物理空间寸土寸金,根本塞不下台式机那种巨大的 DDR5 内存插槽。
因此,它们只能选择 LPDDR5 或 LPDDR5X——直接把内存颗粒紧紧焊接在主板上,贴着 SoC 放。这样既省电,又通过缩短物理距离跑出了非常高的频率,从而在低功耗下凑出了 100 GB/s 以上的带宽。
总结
前文提及的性能倒挂现象,根本原因在于不同芯片对 Decode 阶段内存瓶颈的架构处理存在差异。当标称 100 TOPS 的端侧计算核心受限于传统 LPDDR5 的物理带宽时,系统通常处于内存受限(Memory-bound)状态,计算单元存在大量的空闲等待周期。相比之下,RK1828 通过引入片内 3D 堆叠内存(实现 1024 GB/s 内部带宽),有效降低了数据搬运延迟,从而提升了计算资源的实际利用率。
对比云端(如 RTX 4090、A100)与端侧(如 SA8797、RK1828)的硬件配置路线,当前 AI 系统架构的演进呈现出以下三个技术趋势:
性能评估维度的扩展
在 LLM 自回归推理负载下,系统的瓶颈已由单纯的计算能力(TOPS)向内存带宽(Bandwidth)与容量(Capacity)转移。芯片的有效吞吐量(Tokens/s)不再由单一算力指标决定,内存子系统的规格成为核心制约因素。
存储架构的场景化分化
为突破内存带宽限制,不同终端场景衍生出了差异化的硬件解法:数据中心主要依赖高带宽、高成本的 HBM 方案;端侧通用 SoC 受限于多任务平衡与功耗,普遍沿用统一内存架构(UMA);而专用的端侧推理芯片,则开始向片内 3D 堆叠(近存计算)方向发展,以换取极高的局部带宽。
软硬协同设计(Co-design)的深入
鉴于物理制程与成本对硬件带宽提升的客观限制,算法层的适配成为必然路径。FlashAttention 基于片上 SRAM 的数据分块调度(Tiling),以及 Online Softmax 基于寄存器的增量计算机制,均证明了硬件感知算法(Hardware-Aware Algorithm)在减少片外内存访问(Off-chip DRAM access)和提升算力利用率方面的关键作用。
大语言模型的部署需求正在重塑端侧 AI 芯片的设计规范。总线架构、内存位宽以及多级缓存的协同调度,在芯片设计中的权重已显著提升。底层硬件对特定计算模式的优化,结合算法对底层硬件特性的适配,构成了下一阶段系统架构演进的基础逻辑。
补充资料
RK1828规格
| Feature | RK1828 |
|---|---|
| Process Node | 20nm |
| AI Performance | 20 TOPS (INT8) |
| Precision Support | INT4 / FP8 / FP16 / BF16 |
| Memory | 5GB 3D-Stacked DRAM |
| Memory Bandwidth | 1024GB/s |
| CPU | Triple-core RISC-V 64GCB |
| Interface | PCIe 2.0 x1 / USB 3.0 |
| Typical Power | ~5W |
| Cooling | Passive cooling supported |
| Form Factor | M.2 2280 / SO-DIMM compatible |
| Target Models | Up to 7B LLMs |
RK1828 vs Orin NX vs Hailo-8 vs RK1820
AI Compute and LLM Capability
| Chip | INT8 TOPS | Memory | Target LLM Size | 7B Inference |
|---|---|---|---|---|
| RK1828 | 20 TOPS | 5GB | 7B | 56 tokens/s |
| Jetson Orin NX | 100 TOPS | 8GB LPDDR5 | 7B | 14.5 tokens/s |
| Hailo-8 | 26 TOPS | Host-dependent | ~3B | ~30 tokens/s |
| RK1820 | 20 TOPS | 2.5GB | 3B | 87.7 tokens/s (3B) |
Memory Bandwidth: The Core Architectural Difference
| Platform | Memory Architecture | Bandwidth |
|---|---|---|
| RK1828 | 3D-Stacked On-Package DRAM | 1024GB/s |
| Jetson Orin NX | LPDDR5 | 68GB/s |
| Hailo-8 | External host memory | Lower / host dependent |
Power Efficiency and Thermal Design
| Platform | Typical Power | Cooling Requirement |
|---|---|---|
| RK1828 | ~5W | Passive |
| Orin NX | 10–20W | Active cooling recommended |
| Hailo-8 | ~2.5W | Passive |